Fine-Tuning LLaMA for Multi-Stage Text Retrieval (SIGIR 2024)
论文链接:https://dl.acm.org/doi/abs/10.1145/3626772.3657951 引用数 538
研究方向:
- 信息检索(Information Retrieval, IR)
- 大语言模型(Large Language Models, LLM)
- RAG 检索增强生成(Retrieval-Augmented Generation)
核心模型:
- RepLLaMA:把 LLaMA 微调成检索模型(Retriever)
- RankLLaMA:把 LLaMA 微调成排序模型(Reranker)
论文目标:
探索“大语言模型是否可以替代传统的小型检索模型,成为现代搜索/RAG系统的核心组件”。
相关概念
Multi-stage Retrieval(多阶段检索)
现代搜索系统通常不是一步完成。
典型流程:
用户Query

   ↓

第一阶段 Retriever
(快速找候选)

   ↓

1000篇候选文档

   ↓

第二阶段 Reranker
(精细排序)

   ↓

Top 10结果
论文研究的是整个流程。
论文指出:
传统系统包括:
- retriever:快速生成 top-k 候选;
- reranker:进一步排序提高质量。
Retriever(召回模型)
作用:
从海量数据库中快速找到可能相关内容。
例如:
100亿网页:
↓
找到1000篇。
常见方法:
Sparse Retrieval
例如:
- BM25
依赖:
关键词匹配。
Dense Retrieval(稠密检索)
核心:
把文本转换成向量:
Query

↓

[0.21,0.56,...]

Document

↓

[0.19,0.52,...]
计算:
两个向量距离越近越相关。
代表:
- DPR
- ANCE
- Contriever
Pointwise Reranker
排序模型的一种。
输入:
Query + Document输出:
相关性分数例如:
问题:
什么是BERT?

文本:
BERT是一种语言模型

score=0.95
动机
论文核心问题:
大语言模型时代,LLM 是否能够替代传统的小型预训练模型,成为搜索系统中的 Retriever 和 Reranker?
过去:
搜索系统:
BM25
 ↓
BERT reranker
或者:
DPR
 ↓
BERT/T5 reranker
但是这些模型通常:
- 参数小;
- 上下文长度有限;
- 不是最新 LLM。
与此同时:
GPT、LLaMA 等大模型出现。
问题:
大模型是否真的适合检索任务?
同时
Retrieval 是很多系统基础:
例如:
搜索引擎
Google/Bing:
Query
 ↓
检索网页
 ↓
排序
RAG
现在大模型回答问题:
用户问题

↓

Retriever找到知识

↓

LLM生成答案
如果检索不好:
LLM 会:
- 幻觉;
- 使用错误知识。
论文指出:
Retrieval 对:
- web search
- open-domain QA
- fact verification
非常重要,同时也是 RAG 的关键组件。
核心贡献
这篇论文证明:经过监督微调后的大语言模型 LLaMA 不仅可以生成文本,还可以作为高质量的信息检索器和排序器,在多阶段检索系统中超过传统小模型,并且能够利用长上下文能力直接处理完整文档。
更简单:
以前搜索系统用 BERT、小模型负责“找”和“排”;这篇论文证明 70亿参数级 LLaMA 微调后,可以同时完成这两个任务,并成为新的检索基础模型。
论文摘要明确提出:
作者分别将 LLaMA 微调成:
- dense retriever(RepLLaMA)
- pointwise reranker(RankLLaMA)
并在 MS MARCO 上进行验证。
实验设置
整体:
                 LLaMA-2

                    |
        -------------------------
        |                       |
        ↓                       ↓

  RepLLaMA                RankLLaMA

 Retriever              Reranker

快速召回               精细排序
方法1:RepLLaMA(检索模型)
目标:
让 LLaMA 学会:
Query → vector

Document → vector
然后计算:
Query vector · Document vector如何改造 LLaMA?
LLaMA 是 decoder-only 模型。
不像 BERT:
有 CLS token。
所以作者使用:
输入:
text </s>取最后一个 token:
</s> hidden state作为文本向量。
论文描述:
使用 LLaMA 最后一个 token 的表示作为 query/document embedding。
训练:
使用:
Contrastive Learning(对比学习)
简单理解:
告诉模型:
正确答案:

Query
+
相关Document

距离拉近

错误Document:

距离拉远
方法2:RankLLaMA(排序模型)
输入:
query:
xxx

document:
yyy
一起输入 LLaMA。
输出:
一个分数:
0.92代表相关。
论文采用:
pointwise reranking:
直接预测 query-document 相关性。
数据集
MS MARCO
微软搜索数据集:
包含:
- 真实用户问题;
- 相关文本。
BEIR
跨领域检索 benchmark。
包含:
- 新闻;
- 医疗;
- 科学;
- 问答。
用于测试:
zero-shot 泛化能力。
比较对象
包括:
Retriever:
- BM25
- ANCE
- CoCondenser
- GTR
- Ada2
Reranker:
- monoBERT
- RankT5
- RankGPT
- RankVicuna
实验结果
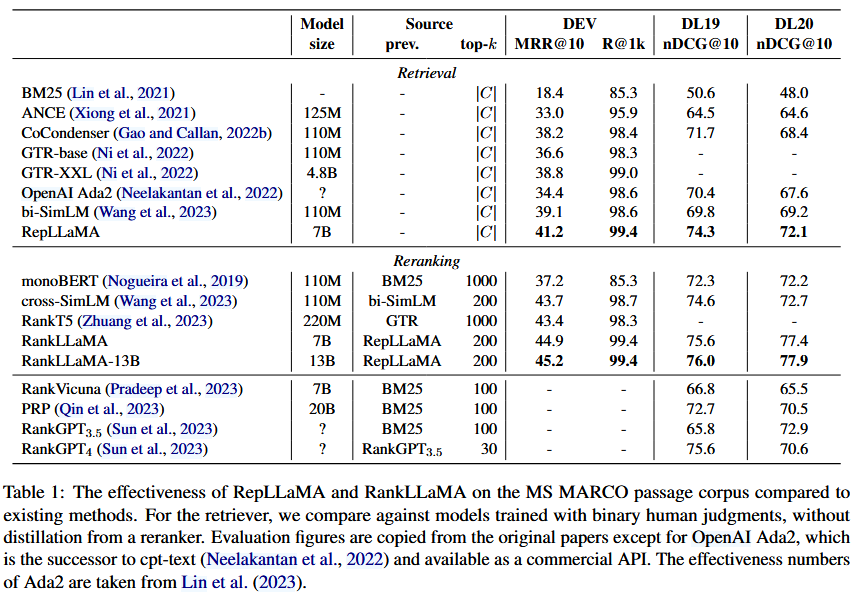
结果1:RepLLaMA 超越传统 Retriever
MS MARCO passage retrieval:
结果:
| 方法 | MRR@10 |
|---|---|
| BM25 | 18.4 |
| ANCE | 33.0 |
| CoCondenser | 38.2 |
| GTR-XXL | 38.8 |
| RepLLaMA 7B | 41.2 |
说明:
大语言模型作为检索器,可以超过传统百亿以下模型。
结果2:RankLLaMA 达到更强排序效果
MS MARCO:
| 方法 | MRR@10 |
|---|---|
| monoBERT | 37.2 |
| RankT5 | 43.4 |
| RankLLaMA 7B | 44.9 |
| RankLLaMA 13B | 45.2 |
说明:
LLaMA 不仅能召回,也能做高质量 reranking。
结果3:长上下文能力减少传统文档切分需求
传统 reranker:
因为 BERT 输入长度有限:
长文档

↓

切成多个片段

↓

分别评分

↓

pooling
称为:
MaxP strategy。
但是 LLaMA:
支持更长输入。
作者发现:
RankLLaMA 可以直接处理完整文档。
论文指出:
传统方法需要 segmentation,而 LLaMA 长上下文能力可以减少这种需求。
结果4:Zero-shot 泛化能力强
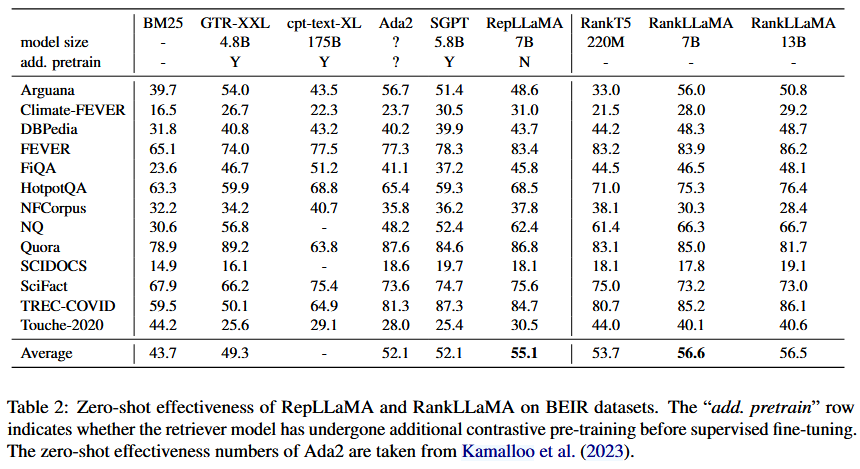
BEIR:
RepLLaMA 和 RankLLaMA 在多个领域表现优秀。
例如:
平均:
RepLLaMA:
55.1
RankLLaMA:
56.5
超过很多已有模型。
相关意义
学术意义
作者认为:
LLM 不应该只被看作生成模型,也可以成为检索模型。
过去:
Encoder模型
负责理解文本

Decoder模型
负责生成文本
这篇论文说明:
Decoder-only LLM:
例如:
LLaMA
也可以:
- 表示文本;
- 学习语义匹配;
- 完成排序。
对 RAG 的意义
这是非常重要的一点。
RAG:
问题

↓

Retriever

↓

知识

↓

LLM回答
以前:
Retriever:
BERT/DPR
Generator:
GPT/LLaMA
未来:
可能:
LLaMA

↓

Retriever

↓

LLaMA

↓

Generator
统一模型体系。
工业意义
论文提供:
RepLLaMA / RankLLaMA checkpoint。
可以直接用于:
- 搜索;
- 企业知识库;
- RAG。
局限性
局限1:计算成本非常高
7B/13B 模型:
训练:
需要:
16 × 32G V100 GPU。
2310.08319v1
相比:
BERT:
百万级参数。
部署成本明显更高。
局限2:检索速度问题
Retriever:
需要:
大量文档编码。
例如:
整个数据库:
100亿文档

↓

每个4096维向量
存储巨大。
论文中:
MS MARCO passage index:
135G。
2310.08319v1
局限3:没有解决所有检索问题
例如:
专业领域:
- 医学;
- 法律;
- 金融;
需要更多领域训练。
局限4:模型规模提升有限
13B RankLLaMA:
相比7B:
提升很小。
论文发现:
13B MRR@10 只提升约0.3。 2310.08319v1
说明:
简单扩大模型并不一定持续提升。
总结
《Fine-Tuning LLaMA for Multi-Stage Text Retrieval》证明了大语言模型不仅可以生成答案,也可以成为搜索系统的大脑:通过微调 LLaMA 得到 RepLLaMA 和 RankLLaMA,可以同时提升召回和排序效果,并利用长上下文能力减少传统检索系统对文本切片的依赖。