Early Exiting BERT for Efficient Document Ranking(2020 SustaiNLP)
论文链接:https://aclanthology.org/2020.sustainlp-1.11/ 引用66
论文全名:
Early Exiting BERT for Efficient Document Ranking
用于高效文档排序的提前退出 BERT
作者:Ji Xin、Rodrigo Nogueira、Yaoliang Yu、Jimmy Lin。论文发表于 2020 年 SustaiNLP:Simple and Efficient Natural Language Processing Workshop,收录于 ACL Anthology,页码 83–88;作者同时公开了实现代码。
这篇论文篇幅不长,但问题非常清楚:
BERT 重排序很准,却太慢;能不能让“容易判断”的文档少算几层,把更多计算留给真正可能相关的文档?
相关概念
MonoBERT
MonoBERT 是一种经典 BERT 重排序器。
它把查询 (Q) 和候选文档 (D) 拼接起来:
[CLS] Query [SEP] Document [SEP]然后让 BERT 同时阅读二者,最后通过 [CLS] 向量判断:
相关
或
不相关
输出的“相关概率”就是该文档的排序分数。 2020.sustainlp-1.11
“Mono”表示模型一次独立判断一个 query–document pair,而不是一次联合排序整个候选列表。
Transformer Layer
BERT-Base 有 12 层 Transformer。
可以粗略理解为:
第1层:处理比较浅的词汇信息
第2层:继续整合上下文
……
第12层:得到最终语义表示
标准 BERT 推理时,所有样本都必须跑完 12 层。
问题是:
- 有些文档明显不相关,可能第 3 层就能判断;
- 有些文档可能真的相关,需要完整计算才能得到可靠分数。
让两者都跑满 12 层,会浪费大量计算。
Early Exiting:提前退出
提前退出是指:
模型在中间层已经足够确定答案时,直接输出,不再计算后面的网络层。
例如:
第1层 → 不确定 → 继续
第2层 → 不确定 → 继续
第3层 → 99%确定不相关 → 提前退出
另一个困难样本可能运行到第 12 层:
第1层 → 不确定
……
第12层 → 输出
所以不同样本使用不同计算量。
这也叫:
- Dynamic Inference:动态推理;
- Adaptive Computation:自适应计算;
- Conditional Computation:条件计算。
Asymmetric Early Exiting:非对称提前退出
这是本文真正有针对性的设计。
作者认为,在文档重排序中:
相关文档
和
不相关文档
不能被平等对待。
因为候选集里通常绝大部分文档都不相关,只有极少数真正相关。对于明显不相关的文档,可以放心早点退出;对于可能相关的文档,则应当更谨慎,让它经过更多层计算。
所以作者分别设置:
[ \tau_p = \text{“相关”类别的退出阈值} ][ \tau_n = \text{“不相关”类别的退出阈值} ]
并采用:
[ \tau_p > \tau_n ]
也就是:
不相关样本可以较早退出,相关样本需要更高置信度,甚至尽量跑完整个模型。
动机
文档重排序有一个特殊的数据特点:
不相关候选极多,真正相关文档极少。
例如 MS MARCO 开发集里,每个 query 有约 1000 个候选,但平均只有约 1 个相关文档。 2020.sustainlp-1.11
也就是说:
约999个负样本
约1个正样本
如果能够让大量“容易识别的负样本”在中间层退出,就可能节省大部分计算。
但相关文档不能随便提前退出,因为:
- 搜索系统真正关心的就是那几个相关文档;
- 相关概率还是最终排序分数;
- 早期层给出的相关分数可能不够精确,导致正确答案排名下降。
因此,作者的关键直觉是:
检索中的正负类别价值不对称,计算预算也应该不对称。
而论文核心研究的是:
如何降低 BERT 文档重排序器的推理成本,同时尽量保持原有排序质量?
MonoBERT 对每一个 query–document pair 都执行完整的 12 层 BERT。
假设每个 query 有 1000 个候选文档:
1个 query
× 1000个候选
× 12层 BERT
即使绝大部分候选明显不相关,也需要完整计算。
这会造成:
- 查询延迟高;
- GPU 成本高;
- 大规模线上部署困难;
- 很难在低延迟搜索系统中使用强重排序模型。
作者指出,BERT 等预训练模型虽然显著提高了 NLP 和信息检索效果,但其计算量和推理延迟妨碍了真实部署。
核心贡献
论文提出了一种面向文档重排序的“非对称提前退出”机制:让明显不相关的候选文档在 BERT 中间层就停止计算,而让可能相关的文档继续运行更多层,从而在基本保持排序质量的同时获得约 2.5 倍推理加速。
浅显易懂的解释是:
搜索系统不必对每个候选答案都花同样多时间;那些一眼就明显错误的答案可以快速淘汰,把计算资源集中在真正有希望的答案上。
实验设置
核心方法
第一步:以 MonoBERT 为基础
每个输入是:
[CLS] Query [SEP] Document [SEP]模型预测该文档是否与查询相关。
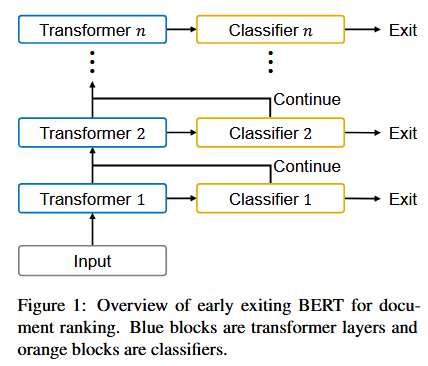
第二步:在 BERT 每一层后加入分类器
标准 MonoBERT 只有最后一层分类器:
12层全部跑完 → 分类本文模型则变为:
第1层 → 分类器1
第2层 → 分类器2
……
第12层 → 分类器12
因此,每个中间层都可以独立给出:
P(相关)
P(不相关)
论文把它称为 multi-output variant of BERT,即具有多个输出路径的 BERT。
第三步:同时训练所有中间分类器
假设第 (i) 层的损失是:
L_i(x,y;\theta)作者将所有层的分类损失直接求和:
L = \sum_{(x,y)\in D}\sum_i L_i(x,y;\theta)通俗理解:
不只要求最后一层学会判断相关性,也要求每个中间层都尽可能具备判断能力。
这比 DeeBERT 使用的两阶段训练更简单:作者一次性联合训练全部分类器。
第四步:推理时逐层判断是否退出
模型每经过一层,就检查:
P_i(\text{相关})>\tau_p或者:
P_i(\text{不相关})>\tau_n只要任一条件满足,就立即输出当前层的相关概率;否则继续进入下一层。
第五步:采用非对称阈值
作者不使用一个统一阈值,而是:
\tau_p>\tau_n实验中的主要设置甚至是:
\tau_p=1这基本意味着:
预测为相关的候选通常不要提前退出,尽量运行到最后;加速主要来自提前淘汰负样本。
作者的逻辑是:
疑似不相关:
可以较早放弃

疑似相关:
宁可多花计算,也不要误判或给出不准确排序分数
这正是本文与普通 Early Exit NLP 方法最大的区别。
实验结果
相关数据集
MS MARCO Passage Ranking
这是搜索和 passage ranking 中非常经典的数据集。
论文构建了:
- 约 832,000 个训练 query–document pairs;
- 正负样本各一半;
- 约 6,900 个开发集 query;
- 每个 query 有 1000 个候选;
- 每个 query 平均约 1 个相关文档。
主要指标为:
[ MRR@10 ]
ASNQ
ASNQ 是答案句选择数据集。
论文从原始约 2000 万 pairs 中构建:
- 约 114,000 个平衡训练 pairs;
- 约 1300 个开发集 query;
- 每个 query 平均约 400 个候选;
- 每个 query 平均约 3 个相关候选。
主要指标包括:
- nDCG@10;
- MRR。
核心结果
核心结果一:约 2.5 倍加速,排序质量几乎不变
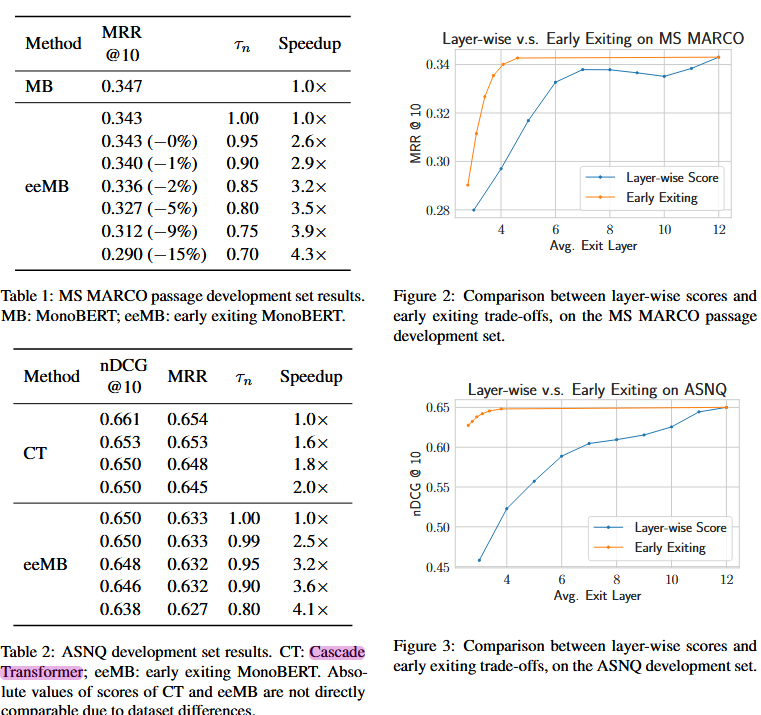
在 MS MARCO 上:
| 方法 | MRR@10 | 负类阈值 (\tau_n) | 加速 |
|---|---|---|---|
| 原始 MonoBERT | 0.347 | — | 1.0× |
| Early Exit | 0.343 | 0.95 | 2.6× |
| Early Exit | 0.340 | 0.90 | 2.9× |
| Early Exit | 0.336 | 0.85 | 3.2× |
当阈值为 0.95 时,模型获得约 2.6 倍加速,MRR@10 从 0.347 降到 0.343,损失非常小。
在 ASNQ 上:
| 设置 | nDCG@10 | MRR | 加速 |
|---|---|---|---|
| 不提前退出 | 0.650 | 0.633 | 1.0× |
| (\tau_n=0.99) | 0.650 | 0.633 | 2.5× |
| (\tau_n=0.95) | 0.648 | 0.632 | 3.2× |
也就是说,在 ASNQ 上约 2.5 倍加速时,两项指标都没有下降。
论文第 4 页的表格把这一质量—速度权衡展示得很清楚。
核心结果二:自适应退出明显优于“所有样本固定在某层退出”
一种更简单的加速办法是:
不做动态判断,直接让所有样本只运行前 6 层。
这样也能减少一半计算。
但问题是:
- 容易样本和困难样本都使用相同计算量;
- 相关文档也被迫在浅层输出;
- 无法针对每个样本动态分配资源。
作者比较了:
固定层退出
vs.
置信度自适应退出
第 4 页的 Figure 2 和 Figure 3 显示,在相似的平均退出层数下,Early Exiting 曲线整体显著高于固定层方法。也就是说:
相同计算预算下,自适应退出的排序质量更高。
这比单纯“砍掉 BERT 后几层”更合理。
核心结果三:正负样本确实应该使用不同阈值
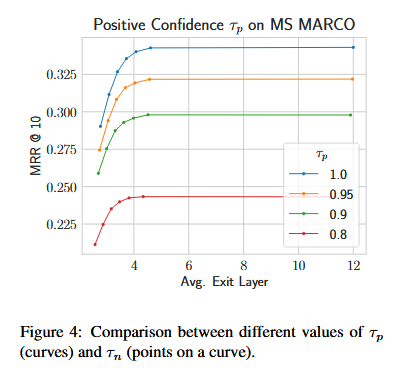
作者进一步改变正类退出阈值 (\tau_p)。
结果显示:
- (\tau_p) 越高,质量—效率权衡越好;
- 当 (\tau_p=1) 时,结果最好;
- 主要应该通过降低负类阈值 (\tau_n),让不相关文档早退;
- 不应轻易让疑似相关文档在浅层退出。
论文第 5 页 Figure 4 中,(\tau_p=1) 的曲线始终位于最上方;较低的正类阈值即使计算量相近,MRR 也明显更差。
这直接支持作者的核心设计:
文档排序不是普通的对称二分类任务;漏掉相关文档的代价远高于多计算几个负样本。
相关意义
1 计算资源不应该平均分给所有候选
标准 BERT 隐含地认为:
所有 query-document pair
都值得计算12层
本文证明,更合理的方案是:
容易的负样本 → 少算
困难或可能相关的样本 → 多算这是一种按样本难度分配计算资源的思想。
2 文档排序与普通分类不同
普通分类任务往往把不同类别平等对待:
猫和狗
正面和负面
类别A和类别B
但文档重排序中:
- 不相关文档数量巨大;
- 相关文档数量极少;
- 最终系统主要依赖相关文档的精确分数;
- 一个相关文档的误判,可能直接导致正确答案消失。
因此,作者认为 early exit 机制必须结合信息检索任务结构,而不能简单照搬通用 NLP 的对称阈值。
这是本文最重要的学术价值:
把通用的 Early Exit 思想改造成适合检索排序的不对称动态推理机制。
3 为高精度重排序器的真实部署提供了低成本路径
本文没有重新设计更小的网络,也没有蒸馏一个学生模型,而是保留原来的 BERT 主体,只增加中间分类头。
优点是:
- 模型结构改动较小;
- 不需要为所有样本固定降低模型深度;
- 可以通过阈值灵活调整速度和质量;
- 同一个模型可以适配不同延迟预算。
例如:
高精度场景:
提高退出阈值

低延迟场景:
降低负类退出阈值
作者最后将其总结为:
根据样本需要分配计算,并通过阈值控制不同的质量—延迟权衡。
局限性
局限一:实验范围较小
论文只测试了:
- BERT-Base;
- MS MARCO Passage;
- ASNQ。
没有验证:
- BERT-Large;
- RoBERTa;
- T5;
- decoder-only LLM reranker;
- 跨领域数据;
- 多语言数据;
- 真实生产搜索流量。
所以论文证明的是:
方法在两个经典英文排序数据集上有效,
而不是已经证明它对所有 reranker 都有效。
局限二:“加速倍数”主要由平均退出层数估算
作者使用 average exit layer 衡量计算效率,并表示该指标在实验中与 wall-clock runtime 成比例。 2020.sustainlp-1.11
但在真实 GPU 系统中,动态退出可能造成:
- 同一 batch 中样本退出层不同;
- 动态 batching 更复杂;
- GPU 利用率下降;
- 控制流和数据搬运产生额外开销。
因此:
平均只算 4 层,不一定就严格等于实际延迟缩短 3 倍。
论文没有系统报告:
- 每秒查询数;
- p50/p95 延迟;
- 不同 batch size;
- CPU/GPU 实际 wall-clock latency;
- 能耗。
对于一篇效率论文,这是较明显的不足。
局限三:没有统计显著性和置信区间
MRR 从:
0.347 → 0.343虽然很小,但论文没有给出:
- 显著性检验;
- bootstrap confidence interval;
- 多次随机种子结果。
因此,“质量几乎不下降”在实践上是合理的,但统计可靠性展示得不充分。
总结
本文提出了非对称提前退出BERT用于文档排序,这是一种有效提升模型在信息检索任务中效率的方法。计算资源根据样本的需求分配。实验表明,该方法能够通过设置不同的阈值实现不同的质量-延迟权衡,并且在基线条件下提升了模型效率。