Passage Re-ranking with BERT 2019 arxiv
论文链接:https://arxiv.org/abs/1901.04085 引用数2118
相关概念
信息检索(Information Retrieval, IR)
简单理解:
当用户输入一个问题时,系统如何从大量文本中找到最相关答案。
例如:
用户搜索:
“BERT是什么?”
系统面对:
10亿篇网页
↓
找到相关网页
↓
排序
↓
返回最相关几个
这就是信息检索。
Passage(文本片段)
搜索系统通常不是直接处理整篇文章,而是切成很多小段:
Wikipedia文章
        ↓
paragraph 1
paragraph 2
paragraph 3
...
每一个小段叫:
Passage(文本片段)
Retrieval 和 Re-ranking 的区别
现代搜索通常分两阶段:
用户Query
    |
    ↓
第一阶段:快速召回
    |
    ↓
1000个候选文档
    |
    ↓
第二阶段:精细排序
    |
    ↓
Top10结果
其中:
Retrieval(召回)
目标:
快速找到可能相关的内容。
常用:
- BM25
- Dense Retrieval
特点:
- 快;
- 粗;
- 允许一定错误。
Re-ranking(重新排序)
目标:
对已经找到的一小批候选进行更加准确的排序。
特点:
- 慢;
- 准;
- 可以使用更复杂模型。
本文研究的就是第二阶段。
论文明确说明,一个问答系统通常先使用 BM25 等方法召回约 1000 个候选 passage,然后使用更复杂的方法重新排序。 1901.04085v5
BERT 是什么?
BERT:
Bidirectional Encoder Representations from Transformers
中文:
双向 Transformer 编码模型。
简单理解:
以前模型读:
我喜欢苹果可能主要按照顺序理解。
BERT 可以:
        苹果
       ↗ ↓ ↖
我  喜欢
同时利用上下文理解:
“苹果”这里到底是:
- 水果?
- 公司?
BERT 最大贡献:
通过大规模无监督文本训练,学习通用语言理解能力。
Cross Encoder(交叉编码器)
本文核心思想。
假设:
Query:
什么是BERT?Passage:
BERT是一种预训练语言模型...Cross Encoder 输入:
[CLS]
什么是BERT?
[SEP]
BERT是一种预训练语言模型...
[SEP]
BERT 一次性阅读:
问题 + 文档然后判断:
这两个东西匹不匹配。
优点:
非常准确。
缺点:
计算慢。
动机
论文关注:
如何让搜索系统更准确判断一个文本片段是否真正回答用户的问题?
传统搜索方法:
例如 BM25:
用户:
python remove list item文档:
Python provides list.remove()因为关键词:
python
remove
list匹配,所以排名高。
但是:
语言真正含义可能不同:
用户:
How to delete an element from Python list?文档:
Deleting files from Python directory关键词也类似,但不是答案。
因此需要:
理解语义,而不仅仅匹配词。
同时还有背景相关客观条件也逐渐成熟:
- 大型问答数据集出现(例如MS MARCO)
- BERT 出现(自然语言理解与推理能力进一步提升)
核心贡献
这篇论文证明:直接将预训练语言模型 BERT 用作搜索系统第二阶段的文本重排序器,可以显著提升问答检索效果,并首次展示了 BERT 在 passage re-ranking 任务上的强大能力。
更通俗:
以前搜索系统只是“根据关键词找答案”,这篇论文让 BERT 直接阅读“问题和候选答案”,判断哪个答案最相关,从而大幅提高搜索排序质量。
论文摘要指出,该方法在 TREC-CAR 数据集达到 SOTA,并成为 MS MARCO passage retrieval 排行榜第一,MRR@10 相比此前最佳方法提升约 27%。
实验设置
整体流程:
用户问题 Query

        ↓

BM25召回1000个候选Passage

        ↓

BERT重新判断每个Passage相关性

        ↓

输出新的排序结果
Step 1:输入 Query + Passage
例如:
Question:
What is BERT?

Passage:
BERT is a transformer based model...
组成:
[CLS]
Question
[SEP]
Passage
[SEP]
送入 BERT。
论文将:
- query 当作 sentence A;
- passage 当作 sentence B。
Step 2:使用 CLS 判断相关性
BERT 输出:
[CLS] hidden vector这个向量代表:
整个问题和文本的关系。
然后接一个分类器:
CLS vector

      ↓

Linear layer

      ↓

Relevant probability
论文使用 BERT-large,并将 CLS 向量输入一个单层神经网络,预测 passage 是否相关。
Step 3:重新排序
例如:
BM25:
A  0.7
B  0.6
C  0.5
BERT:
A 0.65
B 0.92
C 0.3
最终:
B
A
C
实验结果
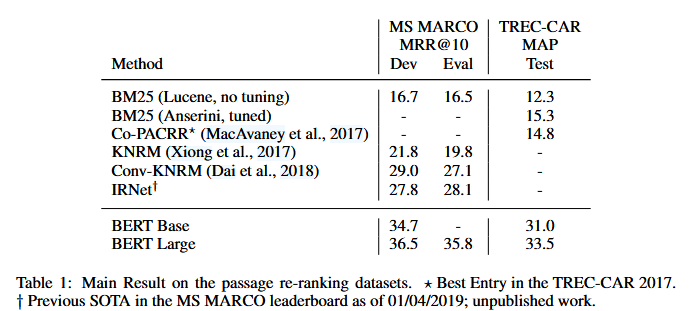
结果1:BERT Re-ranker 大幅超过传统方法
论文实验:
数据集:
- MS MARCO
- TREC-CAR
指标:
MRR@10
解释:
前10个结果中,正确答案排名越靠前,分数越高。
结果:
| 方法 | MS MARCO MRR@10 |
|---|---|
| BM25 | 16.5 |
| IRNet | 28.1 |
| BERT Base | 34.7 |
| BERT Large | 35.8 |
1901.04085v5
结论:
BERT 作为排序模型明显超过传统神经排序方法。
结果2:只需要少量训练数据,BERT 就能超过之前 SOTA
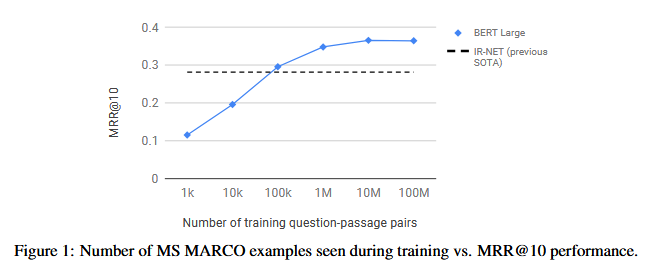
论文发现:
BERT-large:
只训练:
100k query-passage pairs
已经超过之前最好方法 IR-NET。
论文指出:
100k 样本只占 MS MARCO 训练数据不到 0.3%,但 MRR@10 已经提升。 1901.04085v5
说明:
预训练语言知识非常重要。
结果3:BERT 可以成为搜索系统第二阶段核心模型
论文最终证明:
传统搜索:

BM25
 ↓
答案

升级:

BM25
 ↓
BERT Re-ranker
 ↓
答案
可以成为新的工业搜索架构。
相关意义
学术意义
这篇论文证明:
预训练语言模型不仅适合文本理解任务,也适合信息检索排序任务。
此前搜索领域主要依赖:
- BM25;
- TF-IDF;
- 特征工程;
- 专门设计的神经排序模型。
BERT 带来了新的范式:
预训练语言模型

↓

理解query和document关系

↓

排序
工业意义
这篇论文直接影响后来大量系统:
例如:
Google Search:
第一阶段:
快速召回

第二阶段:
BERT类模型重新排序
现在大量:
- 搜索引擎;
- RAG系统;
- 问答系统;
都采用类似架构。
局限性
局限1:计算成本高
这是最大问题。
BM25:
一次搜索
毫秒级
BERT:
需要:
Query + 每个候选passage
分别输入模型
如果:
1000候选:
需要:
1000次BERT推理。
因此不能直接替代召回。
局限2:只负责排序,不负责召回
BERT re-ranker:
无法发现:
BM25根本没有召回的答案。
如果正确答案:
不在候选1000里面,
BERT也无能为力。
局限3:任务较简单
它主要研究:
query-passage relevance不是:
- 长文档理解;
- 多轮对话;
- RAG生成;
- 事实验证。
总结
《Passage Re-ranking with BERT》证明了:搜索系统不应该只依赖关键词或向量距离,而应该让一个强大的语言模型直接阅读“用户问题 + 候选文本”,判断二者是否匹配;这一思想成为今天 RAG 中 reranker 模块的基础。