Beyond Sequential Reranking: Reranker-Guided Search Improves Reasoning Intensive Retrieval (ICLR 2026 Oral )
论文链接: https://doi.org/10.48550/arXiv.2509.07163 引用数4
相关概念
1.Proximity Graph:近邻图
把每篇文档看成一个节点,相似文档之间连接一条边:
D1 —— D2 —— D3
 |      |
D4     D5
如果 D1 和 D2 在向量上相似,就建立连接。
这样系统不仅可以从 query 找文档,也可以:
从一篇有希望的文档,继续探索它周围的相似文档。
2.ANNS / DiskANN
ANNS 是 Approximate Nearest Neighbor Search,近似最近邻搜索。
它的目标是:
不必逐个比较所有文档,也能快速找到向量上比较接近的候选。
DiskANN 是一种图结构的近似最近邻算法。本文使用 DiskANN 构建文档之间的 proximity graph,并把它作为 RGS 搜索的基础
3.Reranker Budget:重排序预算
LLM reranker 计算成本高,不可能检查整个语料库。
因此论文限制:
Reranker@100表示重排序器最多检查 100 篇文档。
还测试了:
- Reranker@100;
- Reranker@300;
- Reranker@500。
论文把这种固定重排序文档数量的设置称为 Reranker@k。
4.NDCG@10
NDCG@10 是检索排序指标。
它不仅检查:
正确文档有没有出现在前 10 名,
还考虑:
正确、最相关的文档是不是排得足够靠前。
数值越高,排序质量越好。
动机
在一些复杂逻辑的任务中例如
- 数学和科学推理;
- 指令遵循检索;
- 多模态检索;
- RAG 中的复杂知识检索;
- query 和答案词汇重合很低的场景。
在这些任务中,真正相关的文档不一定和 query 表面相似。
例如:
Query:一个涉及正弦函数、振幅和导数的数学问题向量检索可能优先找到:
C1:讲简谐运动和振幅它词汇相似,但不能解决问题。
真正有用的文档可能是:
D3:讲洛必达法则它与 query 的词语重合不高,却提供了正确的数学方法。
而论文研究的核心问题就是:
当 LLM reranker 的调用次数有限时,应该把宝贵的计算预算用在哪些文档上,才能最大化检索准确率?
也可以写成:
固定 reranker 预算下,如何选择最值得检查的文档?
传统方法默认:
Embedding 排名第 1~100
全部送给 reranker
但这不是最合理的预算分配方式。
因为 embedding 可能擅长识别表面语义相似,却无法识别复杂推理关系。正确文档可能排在:
第500名
第1000名
甚至第2812名
如果只 rerank Top-100,正确答案永远不会被看到。论文认为,LLM reranker 虽然强,但成本高,因此最终性能同时受到两个因素限制:
- 初始向量检索能不能把答案送进候选集;
- 重排序预算够不够大。
核心贡献
这篇论文把 reranker 从“只能对已有候选重新排序的裁判”,升级成了“主动决定下一步搜索哪里的导航员”,使系统在固定计算预算下能够找到原本不在初始 Top-k 中的高质量文档。
再通俗一点:
传统方法只让强模型在检索器选出的固定名单里挑答案,而 RGS 让强模型一边判断候选、一边决定接下来沿哪些文档继续搜索。
论文将这一方法称为:
Reranker-Guided Search,RGS。
它不再简单顺序扫描 embedding 排名中的前 k 篇文档,而是利用文档相似图和 reranker 反馈,动态寻找更有希望的文档。
实验设置
核心方法
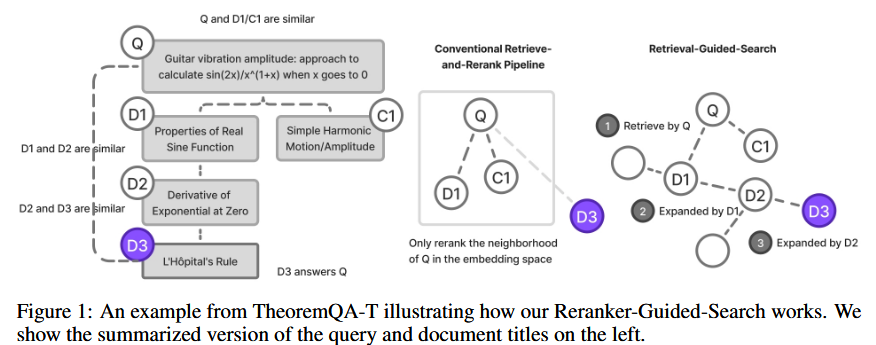
RGS 的方法可以拆成四步。
第一步:预先构建文档相似图
使用文档 embedding 和 DiskANN,为语料库建立 proximity graph:
相似文档之间连边例如:
D1 —— D2 —— D3
       |
       D4
这里的边只表示:
两篇文档在 embedding 空间中相似。
第二步:找到少量起始文档
新 query 到来后,先用普通向量搜索找到若干 seed documents:
Query
  ↓
初始向量检索
  ↓
D1、C1……
这一步只是给图搜索一个起点。
第三步:由 reranker 判断哪些文档最值得继续扩展
RGS 将初始文档交给 LLM reranker。
假设 reranker 判断:
D1 分数高
C1 分数低
系统就不会继续浪费预算探索 C1 周围的文档,而会优先查看 D1 的邻居:
D1 → D2然后 reranker 又判断 D2 有希望,于是继续:
D2 → D3第四步:不断“扩展—重排”,直到预算耗尽
完整过程是:
1. 选择当前排名最高、尚未扩展的文档
2. 加入它的图邻居
3. 用 reranker 对新候选排序
4. 再扩展当前最有希望的候选
5. 达到预算后停止
论文中的算法维护一个有序候选列表 (A),每次选择最靠前但尚未扩展的文档,加入它的邻居,再利用 listwise reranker 更新候选顺序。
因此,RGS 和传统方法的根本差别是:
传统方法:
Embedding 决定看哪些文档
Reranker 只负责最终排序

RGS:
Embedding 提供文档之间的道路
Reranker 决定沿哪条路继续搜索
相关数据集
作者选择了三个比较困难的 benchmark,而不是只使用普通关键词检索数据集。
BRIGHT
BRIGHT 是推理密集型检索 benchmark,包含 12 个领域的自然用户问题,例如:
- Biology;
- Earth Science;
- Economics;
- Psychology;
- Robotics;
- Stack Overflow;
- LeetCode;
- TheoremQA。
它的 hard negative 可能和问题话题高度相关,却不满足题目的具体推理要求。
也就是说,系统不能只靠:
主题相似而必须理解:
这篇文档是否真正提供了解题条件或推理方法。FollowIR
FollowIR 测试检索模型是否能够遵循细粒度用户指令。
同一 query 配上不同指令后,正确结果可能不同。
例如用户可能要求:
寻找支持某观点的文档也可能要求:
寻找反驳某观点的文档它来源于三个 TREC 数据集,并由人工为 query 添加不同检索指令。 2509.07163v1
M-BEIR
M-BEIR 是多模态检索 benchmark,覆盖 8 种 query-corpus 模态组合,例如:
- 文本查询 → 图像;
- 图像查询 → 文本;
- 图像+文本查询 → 图像+文本。
模型不仅要理解语义,还需要跨文本和图像模态匹配。
论文实验使用 CLIP 作为 M-BEIR 的 embedding 模型,并从该 benchmark 随机抽取 100 个 query 进行测试。
相关配置
实验中使用的模型
作者采用:
- BRIGHT、FollowIR:BGE-Large embedding;
- M-BEIR:CLIP embedding;
- Reranker:Gemini-2.0-Flash;
- 主要指标:NDCG@10;
- 预算:Reranker@100、300、500。
实验结果
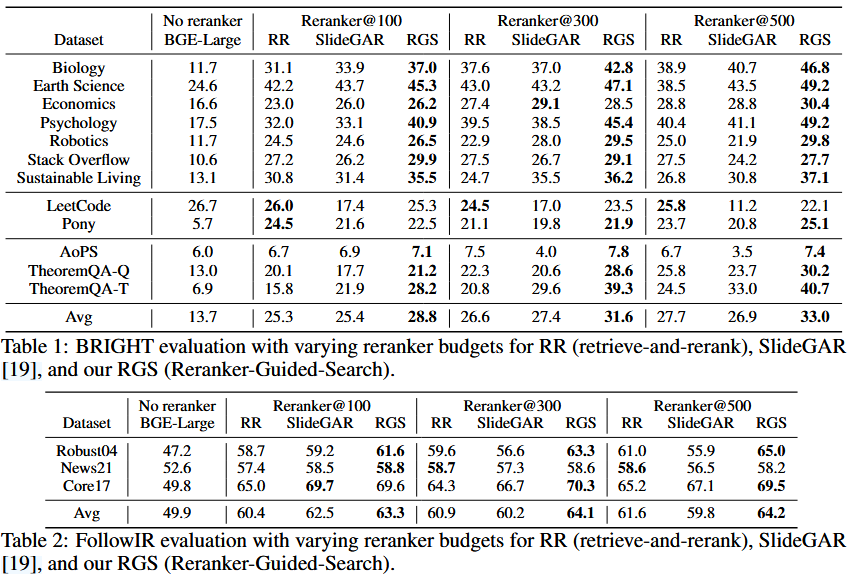
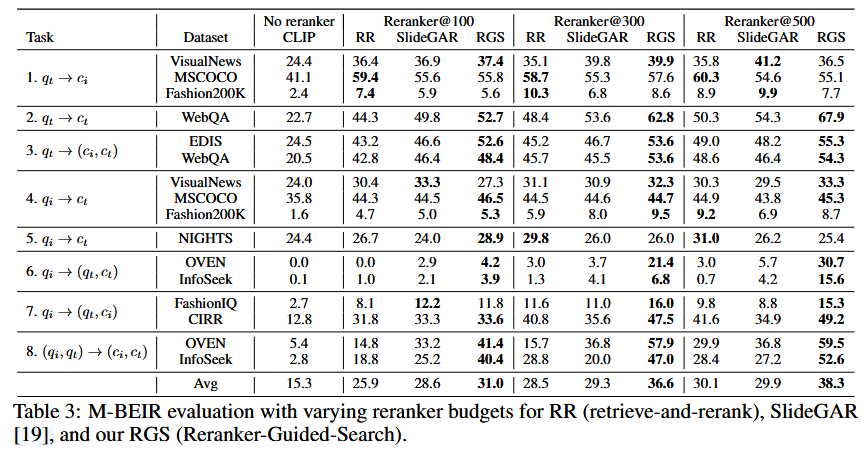
核心结果一:相同预算下,RGS 显著优于传统顺序重排序
在只允许 reranker 查看 100 篇文档时:
| 数据集 | 传统 Retrieve-and-Rerank | RGS | 绝对提升 |
|---|---|---|---|
| BRIGHT | 25.3 | 28.8 | +3.5 |
| FollowIR | 60.4 | 63.3 | +2.9 |
| M-BEIR | 25.9 | 31.0 | +5.1 |
这意味着:
模型、embedding 和 reranker 都没有改变,仅仅重新设计“哪些文档值得 rerank”,就可以明显提升最终结果。
这也是直接回答论文研究问题的最重要结果。
核心结果二:预算越大,RGS 在困难任务上的优势通常越明显
在 Reranker@500 下:
| 数据集 | 传统顺序重排序 | RGS |
|---|---|---|
| BRIGHT | 27.7 | 33.0 |
| FollowIR | 61.6 | 64.2 |
| M-BEIR | 30.1 | 38.3 |
在 BRIGHT 上,RGS 相对传统方法提升约 19%;在 M-BEIR 上提升约 27%。
FollowIR 的提升相对较小,作者给出的解释是:
- FollowIR 中超过 87% 的正确文档本来就在 embedding Top-100 中;
- BRIGHT 中这一比例只有约 31%。
因此,FollowIR 没有太多必要向 Top-100 之外搜索,而 BRIGHT 更容易受益于图扩展。
核心结果三:RGS 对 query embedding 错误更鲁棒,但依赖文档图结构
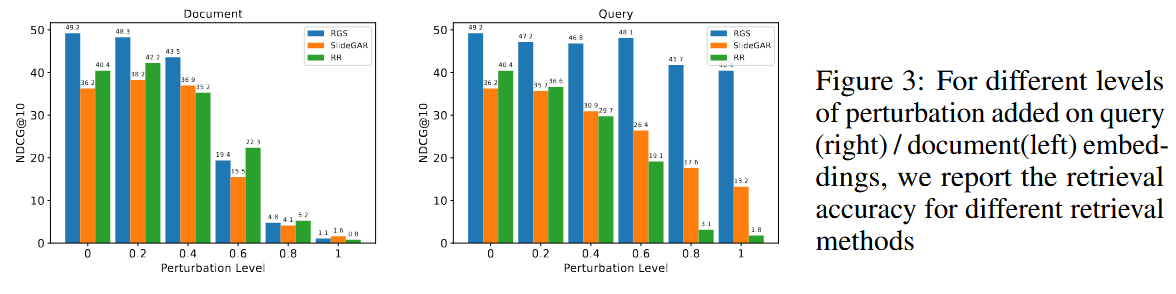
作者对 query embedding 加入越来越强的噪声。
传统 Retrieve-and-Rerank 的性能随着 query embedding 被破坏而迅速下降,因为它完全依赖 query 到 document 的向量排名。
RGS 即使使用几乎无用的 query embedding,性能下降仍然较小。原因是:
- query embedding 主要负责提供起点;
- 后续搜索依靠文档—文档相似图;
- reranker 决定向哪个邻域继续前进。
作者甚至发现,不执行 query 的第一阶段相似搜索、直接从 DiskANN 的默认入口开始,RGS 仍可取得接近的准确率,只是需要更多 reranker 调用。
但是,这不代表 embedding 完全不重要。
RGS 仍然依赖文档之间合理的图结构:
- DiskANN proximity graph:效果最好;
- 普通 KNN 图:可以改善,但搜索较慢;
- 随机图:没有改善。
相关意义
4.1 重新定义了 Retriever 和 Reranker 的关系
传统理解是:
Retriever 决定候选
Reranker 决定候选顺序
本文提出:
Retriever / 文档图提供搜索空间
Reranker 同时决定排序和搜索方向
这让 reranker 不再只是一个被动的后处理模块,而成为一个主动的搜索控制器。
这是本文最重要的概念贡献。
4.2 突破了初始 Top-k 的上限
传统流程存在硬上限:
\text{最终正确文档} \subseteq \text{初始 Top-k}也就是说,初始检索没找到的文档,reranker 无法挽救。
RGS 将搜索范围从固定候选列表扩展为图上的动态路径:
\text{Seed} \rightarrow \text{Relevant Neighbor} \rightarrow \text{More Relevant Neighbor}因此有机会找到初始 query-document 向量排名非常靠后的答案。
4.3 把“重排序预算分配”变成独立研究问题
过去很多论文比较:
- 哪个 embedding 更好;
- 哪个 reranker 更好;
- rerank Top-100 还是 Top-1000。
本文指出,还有一个以前相对被忽视的问题:
即便 embedding 和 reranker 都固定,选择哪些文档交给 reranker,也能显著影响性能。
因此,未来检索系统不仅需要研究模型,还需要研究:
- 搜索策略;
- 自适应候选选择;
- reranker 调用分配;
- graph traversal;
- test-time compute 的使用方式。
4.4 Embedding 更像“导航地图”,reranker 更像“目标判断器”
论文的消融结果显示:
- embedding 模型越强,RGS 越快找到正确邻域;
- 预算足够大时,不同强弱 embedding 的最终结果逐渐接近;
- 最终上限更多由 reranker 能否正确判断相关性决定。
作者据此认为:
embedding 的质量主要影响达到某一准确率需要多少 reranker 调用,而最终准确率主要受 reranker 能力及其与人工标签的一致性限制。
4.5 对 RAG 的实践意义
在 RAG 中,常见做法是:
向量检索 Top-k
↓
Rerank Top-k
↓
把最终文档交给生成模型
RGS 提示了一种新的架构:
向量图提供候选关系
↓
Reranker 动态引导探索
↓
发现初始 Top-k 之外的证据
↓
生成模型回答
因此它特别适用于:
- 复杂科学问题;
- 多跳推理;
- 低词汇重合检索;
- 多模态知识库;
- 初始 embedding 很难准确表示用户意图的任务。
局限性
局限一:主要实验只使用一种 LLM reranker
论文主体使用的是:
Gemini-2.0-Flash。
因此尚不能完全确定结果是否能够稳定推广到:
- Qwen reranker;
- BGE reranker;
- RankLLaMA;
- 小型 cross-encoder;
- 不同 pointwise / pairwise reranker。
论文在算法描述中说可以适配 pointwise reranker,但主体实验主要验证的是 listwise LLM reranker。
局限二:RGS 是自适应串行搜索,难以完全并行
传统方法可以一次性将 Top-100 文档组成 batch 并行 rerank。
RGS 则必须:
先 rerank
↓
根据结果决定扩展哪个节点
↓
再 rerank
后一步依赖前一步的结果,因此并行度会降低。作者自己也在结论中将这一点列为局限。 2509.07163v1
这意味着:
即使总 token 或文档预算相同,实际端到端延迟未必相同。