Breaking the Lens of the Telescope: Online Relevance Estimation over Large Retrieval Sets(2025 SIGIR)
论文链接:https://dl.acm.org/doi/epdf/10.1145/3726302.3729910 引用11
论文题目: Breaking the Lens of the Telescope: Online Relevance Estimation over Large Retrieval Sets
中文可译为:《打破望远镜的视野限制:面向大规模检索集合的在线相关性估计》
发表: SIGIR 2025,全文 11 页。 3726302.3729910
这篇论文不是在研究“如何训练一个更强的重排模型”,而是在研究:
昂贵重排模型只能处理少量文档时,应该让它优先看哪些文档,以及怎样用它已经给出的少量分数,推测其他文档是否值得继续检查。
相关概念
传统检索—重排系统
现代搜索系统一般采用两阶段结构:
数百万篇文档
   ↓
BM25 / Dense Retriever 快速粗排
   ↓
取 Top-100 或 Top-1000
   ↓
Cross-Encoder / LLM 精排
   ↓
最终结果
第一阶段的检索器速度快,但判断不够准确;第二阶段的重排器判断准确,但计算非常贵。
这里的问题是:
真正相关的文档
如果没有进入第一阶段 Top-k
       ↓
后面的重排模型再强也看不到它
       ↓
永远无法被找回来
论文把这种逐级缩小候选范围的结构称为 Telescoping/Cascading Pipeline,望远镜式或级联式检索流程。
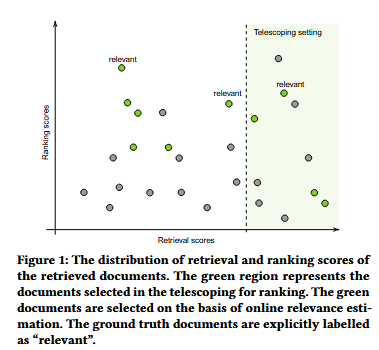
“望远镜”这个标题的含义就是:传统系统越往后看得越清楚,但视野也越来越窄;视野之外的相关文档已经被丢掉了。论文第2页的图1展示了这一现象:一些真正相关的文档虽然拥有较高的精排分数,却因为初始检索分数较低而落在传统重排范围之外。
ORE 的基本想法
ORE 不再一次性确定“只重排最初的 Top-k”,而是循环执行:
先挑一小批文档
      ↓
让昂贵模型给这一批打分
      ↓
根据这些真实分数,学习“什么样的文档更可能相关”
      ↓
重新估计剩余所有文档
      ↓
再挑下一批最值得检查的文档
因此,它有机会把最初排名较低、但后来被判断为有潜力的文档重新捞回来。
动机
现实搜索系统必须同时满足两个相互冲突的目标:
- 搜索质量高: 希望使用Cross-Encoder或LLM判断文档;
- 响应速度快: 不可能让大模型检查数百万篇文档。
因此,关键问题并不是简单地“要不要使用强模型”,而是:
在固定计算预算下,怎样把有限的强模型调用用在最值得检查的文档上?
这个问题不仅影响搜索引擎,还影响电商搜索、事实核查、企业知识库检索和RAG系统。论文强调,级联架构本身广泛存在,而系统最终表现会受到早期检索召回率的限制。
论文主要针对传统多阶段检索中的两个问题。
问题一:第一阶段造成“召回率上限”
假设语料库里有100篇真正相关的文档,但第一阶段只找到了其中60篇。
那么无论后面的重排模型多强:
\text{最终最多只能找到这60篇}它只能重新排列已经进入候选集的文档,不能拯救未进入候选集的文档。
这被论文称为 Bounded Recall Problem,受限召回问题。
问题二:候选文档按照不够准确的初始分数排序
传统系统通常会:
- 按BM25或向量相似度排序;
- 直接取最前面的Top-k;
- 将Top-k交给昂贵重排模型。
但第一阶段的分数只是一个粗略判断。即使重排模型已经对部分文档给出了更准确的相关性信息,传统系统往往也不会利用这些新信息重新调整尚未处理文档的顺序。
现有自适应检索方法 Gar、Quam 虽然会探索已发现文档的邻居,但它们在调度候选文档时仍较依赖固定规则或启发式策略。
核心贡献
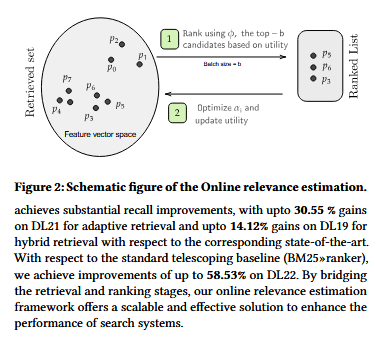
论文提出了在线相关性估计 ORE:针对每个查询,只用少量昂贵重排模型的评分在线学习一个轻量级相关性估计器,然后不断重新安排整个候选池中的文档优先级,从而在减少重排调用的同时,找回传统级联检索过早排除的相关文档。
简单的说可以理解为:
传统搜索系统先粗筛再精排,一旦粗筛漏掉文档,精排再强也救不回来;这篇论文让精排模型一边工作、一边教系统怎样寻找下一批最值得看的文档。
实验设置
核心方法:在线相关性估计 ORE
ORE 全称为:
Online Relevance Estimation,在线相关性估计。
这里的“在线”不是“连接互联网”,而是:
在处理当前查询的过程中,一边获取重排模型的结果,一边即时更新相关性估计器。
它不是提前离线训练一个固定模型,而是针对当前查询动态学习。
ORE 的数学核心
对于查询 (q) 和候选文档 (d),昂贵重排模型给出的分数表示为:
\phi(q,d)例如,\phi可以是 MonoT5 或 RankLLaMA。
ORE 为每篇文档构造一个低维特征向量:
\mathbf{x}_d然后用一个非常简单的线性模型估计昂贵模型的分数:
\widehat r(q,d) = \operatorname{EstRel}(\boldsymbol{\alpha},\mathbf{x}_d) = \boldsymbol{\alpha}^{\top}\mathbf{x}_d其中:
- \mathbf{x}_d:文档的检索和邻接特征;
- \boldsymbol{\alpha}:在线学习的特征权重;
- \widehat r(q,d):ORE预测的文档相关性或效用。
ORE通过最小化下面的平方误差学习权重:
\frac{1}{2} \left[ \phi(q,d) - \boldsymbol{\alpha}^{\top}\mathbf{x}_d \right]^2也就是说:
让轻量线性模型尽量模仿昂贵重排模型已经给出的分数。
论文将昂贵重排器的分数作为在线估计过程的监督信号,但也明确承认:重排器分数本身也只是对真实相关性的估计,并不是真正的人类标注真值。
ORE 的完整执行步骤
设:
- (D_q):当前查询的候选文档池;
- (b):每次选出的文档批大小;
- (c):最终处理的文档总预算;
- (m):允许调用昂贵重排器的批次数量。
论文实验中通常设置批大小 (b=16)。
具体过程如下。
第一步:建立较大的候选池
在混合检索场景中,候选文档来自:
- BM25词法检索;
- TCT稠密向量检索;
- 两者结果的融合。
在自适应检索场景中,还会利用文档图不断加入已选文档的邻居。
第二步:给每篇候选文档计算廉价特征
ORE不会直接让大模型检查所有候选文档,而是先计算BM25分数、向量相似度、文档邻接关系等廉价特征。
第三步:根据估计分数选择一个批次
根据:
\widehat r(q,d)=\boldsymbol{\alpha}^{\top}\mathbf{x}_d选择估计分数最高的 (b) 篇文档。
第四步:用昂贵模型给这批文档打分
例如使用 MonoT5 对16篇文档打分。
这些分数相当于当前查询下的少量“训练样本”。
第五步:更新线性模型
用昂贵模型的真实输出更新 \boldsymbol{\alpha}。
第六步:重新估计剩余文档
用更新后的参数重新计算整个候选池的估计相关性。
一些初始BM25排名较低,但与已确认相关文档非常相似的文档,可能因此被提升。
第七步:重复执行
在昂贵重排预算用完后,ORE继续使用学习到的估计分数安排剩余文档,直到达到总预算 (c)。
算法1给出了上述完整流程:估计、选批、昂贵评分、更新参数、移除已处理文档,再进入下一轮。
具体例子
假设:
- 最终需要选出100篇文档,即 (c=100);
- 每批16篇,即 (b=16);
- 只允许昂贵模型真正处理2批,即 (m=2)。
那么ORE只需要用昂贵模型处理:
2 \times 16=32篇文档。
它再根据这32篇文档的分数,学习当前查询下:
- BM25分数有多重要;
- 向量相似度有多重要;
- 与已发现相关文档相近是否重要。
然后估计剩余候选文档的相关性,而不需要让昂贵模型逐一评分。
这就是论文所说的 Sample Efficiency,样本效率:只观察少量昂贵评分,就能对大量候选文档进行较合理的排序。
ORE 使用了哪些特征?
论文将特征分成两类。
| 特征类型 | 含义 | 例子 |
|---|---|---|
| Q2DAff | Query-to-Document Affinity,查询到文档的相似度 | BM25查询—文档分数、TCT向量相似度 |
| D2DAff | Document-to-Document Affinity,文档之间的相似度 | BM25文档—文档相似度、TCT向量相似度、学习到的图边权重 |
| D2SetAff | Document-to-Set Affinity,候选文档与一组已确认相关文档的接近程度 | 候选文档与当前高分文档集合的平均相似度 |
具体特征包括BM25、TCT、RM3扩展查询分数和文档图中的学习型相似度。
最关键的直觉是:
一篇文档即使与原始查询的表面匹配不强,只要它和若干已经被重排器确认相关的文档非常接近,也可能值得进一步检查。
Multi-Armed Bandit
Multi-Armed Bandit,多臂老虎机问题通常描述:
面对多个未知收益的选择,怎样在“尝试未知选择”和“利用当前最优选择”之间平衡?
映射到本文:
- 每篇候选文档是一台“老虎机”,即一个arm;
- 让昂贵重排器检查文档,相当于拉动一次arm;
- 重排器给出的相关性分数相当于reward;
- 系统需要决定下一批检查哪些文档。
对应两个策略:
- Exploitation,利用: 优先处理初始检索分数高的文档;
- Exploration,探索: 尝试初始分数较低、但与已确认相关文档接近的文档。
ORE利用查询—文档特征和文档—文档特征来平衡这两者。
不过严格来说,ORE的实际实现更接近“Bandit启发的在线线性估计与贪心批次选择”,后文会把这一点作为潜在局限讨论。
相关数据集
论文使用两代 MS MARCO Passage 语料库,并在四个TREC Deep Learning查询集合上评估。
| 测试集 | 对应语料库 | 查询数 | 每个查询平均相关文档数 |
|---|---|---|---|
| TREC DL19 | MS MARCO Passage,约880万段落 | 43 | 58.1 |
| TREC DL20 | MS MARCO Passage,约880万段落 | 54 | 30.9 |
| TREC DL21 | MS MARCO Passage-v2,约1.384亿段落 | 53 | 50.2 |
| TREC DL22 | MS MARCO Passage-v2,约1.384亿段落 | 76 | 58.4 |
实验使用的文档规模很大,尤其MS MARCO Passage-v2包含约1.384亿个段落;不过需要注意,昂贵模型并不会直接扫描全部文档,而是在检索得到的候选池及自适应扩展邻域中工作。
主要指标是:
- Recall@c: 在前 (c) 个结果中找到了多少比例的相关文档;
- nDCG@c: 不仅检查是否找到相关文档,还考虑相关程度和排序位置;
- Latency: 每个查询的重排耗时。
实验结果
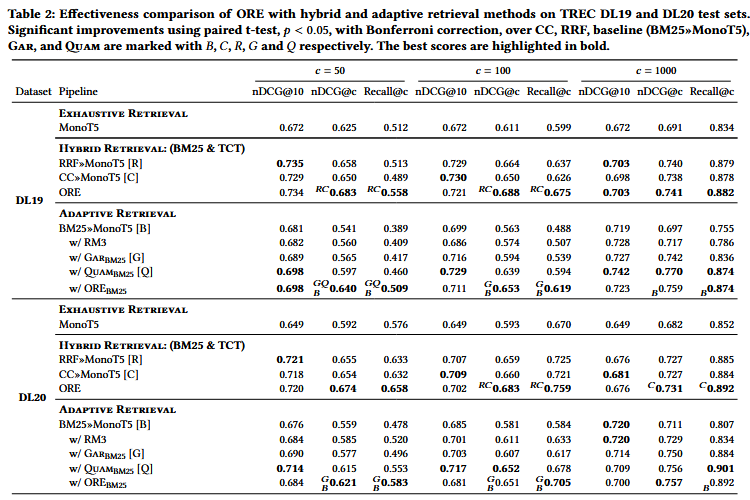
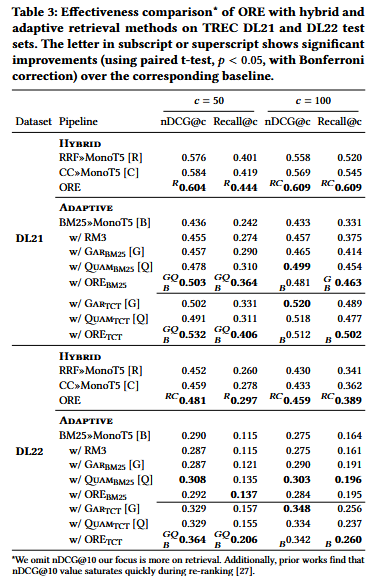
结果一:ORE显著改善了召回率,尤其在低预算下
混合检索场景
在DL19、重排预算为50时:
| 方法 | Recall@50 |
|---|---|
| CC融合 + MonoT5 | 0.489 |
| RRF融合 + MonoT5 | 0.513 |
| ORE | 0.558 |
相对于CC提升约14.11%,相对于RRF提升约8.9%。
在DL21、预算为100时:
| 方法 | Recall@100 |
|---|---|
| RRF + MonoT5 | 0.520 |
| CC + MonoT5 | 0.545 |
| ORE | 0.609 |
相对于CC提升约11.74%,相对于RRF提升约17.12%。
这说明:
相比一次性融合BM25和向量检索结果,ORE可以利用重排过程中新获得的信息,重新提升一些初始融合排名较低的文档。
自适应检索场景
DL21、TCT文档图、预算为50时:
| 方法 | Recall@50 |
|---|---|
| Gar | 0.331 |
| Quam | 0.311 |
| ORE | 0.406 |
相对于Quam提升约30.55%,相对于Gar提升约22.66%。
这是论文报告的最突出召回提升之一。
论文认为,Gar和Quam按照固定规则在“初始列表”和“邻居文档”之间切换;ORE则把所有候选文档放进统一的效用估计框架中,每轮直接选择当前最值得处理的候选,因此在较小预算下更有样本效率。
结果二:只使用很少的昂贵模型评分,估计器就开始有效
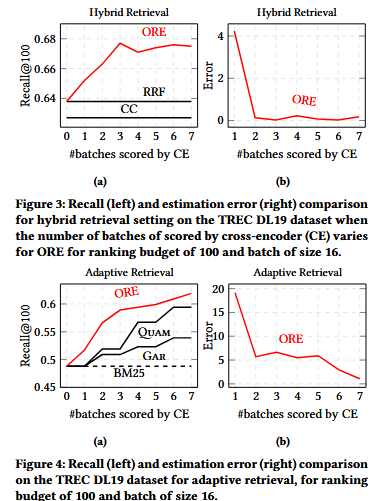
图3和图4研究了:随着交叉编码器实际评分批次数增加,ORE的估计误差和召回率如何变化。
主要现象是:
- 参数随机初始化时,第一批后的估计误差较大;
- 评分批次增加后,估计误差迅速下降;
- 在混合检索中,即使只让交叉编码器处理一个16文档批次,ORE的召回表现已经可以超过RRF和CC;
- 在自适应检索中,ORE在不同重排器预算下通常都优于Gar和Quam。
第8页的图中可以明显看到:随着被Cross-Encoder评分的批次数增加,右侧估计误差下降,左侧Recall上升。
这直接回答了论文的第二个研究问题:
一个极小、在线学习的相关性估计器,确实可以在少量昂贵样本后,成为重排器分数的有用代理。
结果三:ORE减少了昂贵重排器调用,并降低延迟
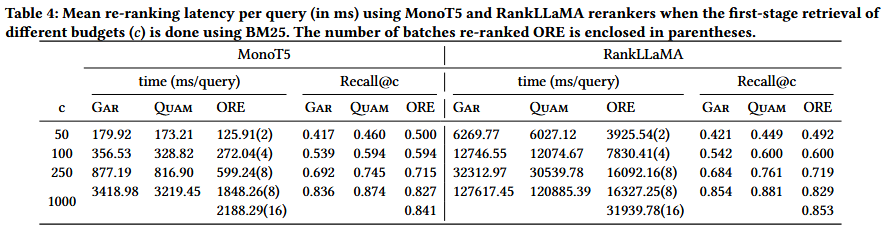
为了达到约0.56的Recall@100:
- ORE只需要约2个交叉编码器评分批次,耗时约102 ms/query;
- Gar需要约8个批次,耗时约238 ms/query。
作者据此报告约2倍的速度提升。 3726302.3729910
在预算 (c=250) 时,论文进一步拆分了ORE的时间:
| 组件 | 约耗时 |
|---|---|
| Cross-Encoder评分 | 602 ms/query |
| 特征查询/构造 | 32.2 ms/query |
| 更新线性参数 | 22.9 ms/query |
交叉编码器约占总重排时间的92%;而ORE自身的特征读取与参数更新加起来,比重排器调用便宜约10倍。
作者报告:
- 使用MonoT5时,通常可获得约2倍左右的速度提升;
- 使用更昂贵的RankLLaMA时,部分配置下报告最高约9倍速度提升。
第9页的表4和图5展示了不同预算、不同重排器下的延迟和召回权衡。
相关意义
从“静态流水线”转向“动态反馈系统”
传统级联检索是:
第一阶段决定候选集
        ↓
第二阶段只能接受这个候选集
ORE则变成:
检索器提出候选
      ↓
重排器给出少量反馈
      ↓
反馈反过来影响后续候选选择
因此,检索和重排不再是完全割裂的两个阶段,而是形成反馈循环。
这是论文最主要的范式贡献。
让昂贵重排器不仅“评分”,还“指导搜索”
传统系统中,Cross-Encoder只负责给已经选中的文档排序。
在ORE中,Cross-Encoder的分数还有第二层作用:
教会一个廉价估计器,怎样寻找下一批文档。
从更广泛的机器学习视角看,这可以理解为一种:
查询级、推理时、在线的轻量教师—学生过程。
昂贵模型是教师,线性估计器是学生;但这个学生不是长期训练的通用模型,而是针对当前查询临时学习。
这是我的概括,论文没有直接使用“在线蒸馏”作为核心命名。
证明“选哪些文档计算”与“模型本身多强”同样重要
很多检索研究关注:
- 换更大的重排模型;
- 换更好的Embedding;
- 增加更多重排深度。
这篇论文强调另一个问题:
即使重排器保持不变,仅仅更聪明地决定下一批检查哪些文档,也能显著改善召回率和效率。
因此,其贡献不是提出新的大模型,而是提出新的计算资源调度方式。
实践意义
作者认为ORE具有以下实践价值:
- 可插拔: 昂贵重排器可以是MonoT5,也可以换成RankLLaMA等模型;
- 轻量: 在线学习的只是一个低维线性模型;
- 预算可控: 可以直接限制昂贵重排器处理多少批次;
- 适用于大候选池: 不必让昂贵模型逐一处理全部候选;
- 适合低延迟系统: 大部分额外开销远低于重排器本身。
作者最终将ORE定位为连接检索和排序阶段的一种可扩展方案。
局限性
局限一:四个评测集仍属于同一个MS MARCO/TREC-DL体系
虽然论文使用了四个测试集和两个规模不同的语料库,但它们本质上都属于英文段落检索场景。
论文没有证明ORE在以下任务中同样有效:
- 多语言检索;
- 长文档检索;
- 电商产品检索;
- 法律、医疗等专业领域;
- RAG知识库;
- 多跳检索;
- 代码检索。
因此,“跨领域普适性”仍需进一步验证。
局限二:依赖昂贵重排器本身足够可靠
ORE学习的目标不是人类相关性标签,而是:
\phi(q,d)即MonoT5或RankLLaMA的输出。
如果重排器存在系统偏差,例如:
- 偏好长文档;
- 无法识别某类专业术语;
- 在域外查询上评分失真;
那么ORE可能会更高效地复制这种错误。
论文也明确指出,重排器分数本身只是对真实相关性的估计。
局限三:特征设计仍然较人工,并依赖额外基础设施
ORE依赖BM25、TCT、RM3、文档邻接图、学习型Affinity等特征。
这意味着实际部署时可能需要:
- 维护多个检索索引;
- 提前构建文档图;
- 保存文档—文档相似度;
- 为不同任务重新选择特征。
因此,ORE的轻量主要指在线估计模型本身轻量,不代表完整系统没有额外存储和离线构建成本。
局限四:论文报告的主要是重排阶段延迟,而不是完整端到端延迟
表4明确测量的是:
在BM25第一阶段检索已经完成后,后续重排过程的平均延迟。
因此,部分成本没有完整计入,例如:
- 第一阶段检索时间;
- 构建或加载语料图的成本;
- 多检索器并行检索成本;
- 大规模特征存储和访问成本。
所以生产系统中的真实端到端收益还需要进一步测试。
局限五:ORE主要提升召回,不保证所有Top-rank指标都最好
例如在DL19、预算100的混合检索中:
- ORE的nDCG@10为0.721;
- RRF为0.729;
- CC为0.730。
在DL20、预算50的自适应检索中:
- ORE的nDCG@10为0.684;
- Quam为0.714。
因此更准确的结论是:
ORE特别擅长改善候选覆盖率和Recall,但不一定在所有设置下都能提高最前面十个结果的精排质量。
这也是论文在DL21和DL22表格中省略nDCG@10、强调Recall和nDCG@c的原因之一。
局限六:最高速度提升有时伴随召回损失
例如表4中,RankLLaMA、预算1000时:
- Quam:Recall约0.881,耗时约120885 ms;
- ORE较高质量配置:Recall约0.853,耗时约31940 ms;
- ORE更快配置:Recall约0.829,耗时约16327 ms。
ORE确实快得多,但召回率并未完全达到Quam。
因此“最高9倍加速”不能简单理解成:
在完全相同质量下无条件获得9倍加速。
更准确的表述是:
ORE提供了更有吸引力的质量—延迟折中,在部分高预算配置中通过轻微质量损失换取大幅速度提升。
总结
ORE是一种结构简单、工程意义较强的在线候选调度框架,最有说服力的结果是低预算下的召回提升和样本效率;其跨领域泛化、完整端到端成本、Top-rank精度以及严格Bandit理论支撑仍有待进一步验证。