Reproducing Adaptive Reranking for Reasoning-Intensive IR(SIGIR 2026)
论文链接:https://dl.acm.org/doi/abs/10.1145/3805712.3808568
论文题目可以译为:
《在推理密集型信息检索中复现自适应重排序》
这篇工作发表于 SIGIR 2026 Reproducibility Track(可复现性赛道)。它不是重新发明 GAR,而是把 2022 年提出的 Graph-based Adaptive Re-ranking,图式自适应重排序,迁移到更困难的 BRIGHT 推理检索任务中,检验原结论是否仍然成立。官方 SIGIR 2026 会议程序和录用列表均将其列为 Reproducibility 论文。
论文同时公开了代码、索引和图构建流程,仓库支持复现实验中的 BRIGHT 数据预处理、BM25 索引和 corpus graph 构建。
相关概念
信息检索与“推理密集型检索”
普通信息检索通常依赖:
- 关键词重合;
- 主题相似;
- 向量语义相似。
例如查询:
“如何在 Python 中删除列表元素?”
包含 Python、list、delete 的文档通常就比较容易找到。
但 Reasoning-Intensive IR,推理密集型信息检索 要求系统理解更深层的逻辑关系。论文沿用 BRIGHT 的定义:这类任务仅靠词汇或语义相似度不足以找到相关文档。 2604.27577v1
例如编程问题中,相关文档可能:
- 没有重复 query 中的关键词;
- 但包含解决问题所需的算法逻辑。
数学问题中,相关文档可能:
- 不直接提到题目表面的函数名;
- 却介绍了正确的定理或推导方法。
Bounded Recall:有界召回问题
这是理解全文最关键的概念。
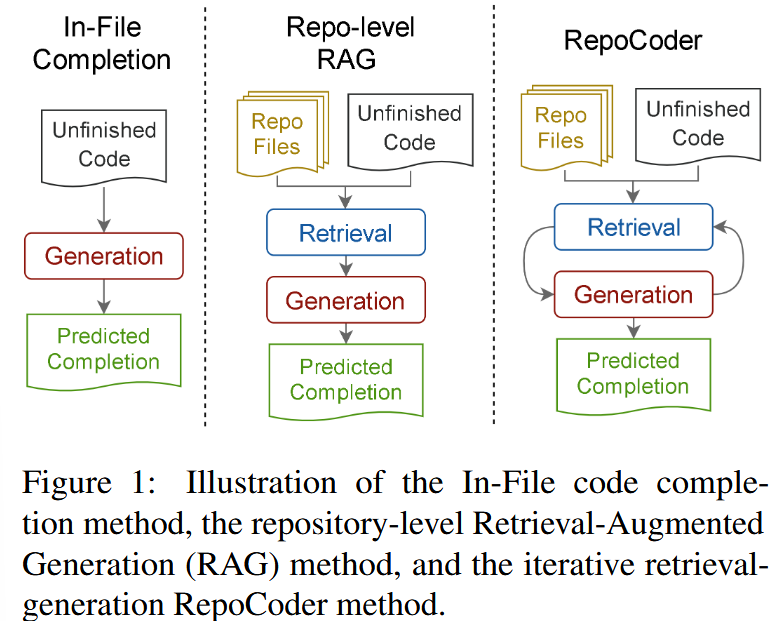
传统流水线只允许 reranker 查看初始 Top-(k):
R_{\text{final}}\subseteq R_{\text{initial Top-}k}假设真正相关文档被 BM25 排在第 500 名,而系统只重排前 100 名:
真正相关文档:第500名
重排序范围:第1~100名
那么无论 reranker 多强,它都不可能把第 500 名文档救回来。
这就是:
最终结果受到第一阶段候选集召回率的硬性上限约束。
论文称之为 bounded recall problem。
GAR:Graph-based Adaptive Re-ranking
GAR 是原始方法的名称:
基于语料图的自适应重排序。
它不是简单地按初始 BM25 排名依次检查:
第1名 → 第2名 → 第3名 → ...而是建立一个 corpus graph,语料图:
文档A —— 文档B
   \       |
    文档C —— 文档D
图中:
- 节点是文档;
- 边表示两个文档在 BM25 或 embedding 空间中比较相似。
如果 reranker 判断文档 A 相关,那么 GAR 会进一步检查 A 的邻居,因为根据 clustering hypothesis,聚类假设:
对同一个 query 相关的文档,往往在文档空间中也彼此接近。
Adaptive Reranking:自适应重排序
传统重排序:
提前固定好100篇文档
→ 全部评分
自适应重排序:
先评分一批
→ 根据评分决定下一批看谁
→ 继续评分
所以 GAR 的候选集并不是固定不变的,而会随着 reranker 的结果动态扩展。
Corpus Graph:语料图
本文使用 BM25 构建图:
- 把每篇文档暂时当作一个 query;
- 用 BM25 找到最相似的 (k) 篇文档;
- 把这些文档作为它的图邻居。
图是在查询前离线建立的,不需要对每个用户 query 重新构建。本文因为资源限制,只复现了 BM25 图,没有测试原 GAR 中的 TCT-ColBERT 稠密语义图。
Graph Frontier:图前沿
图前沿可以理解为:
当前已经发现、但还没有交给 reranker 检查的邻居文档集合。
例如:
已重排文档A
    ↓
发现邻居B、C、D
    ↓
B、C、D进入Graph Frontier
GAR 会从初始 BM25 列表和 graph frontier 中交替选择下一批文档。
Reasoning / Thinking Reranker
论文把 reranker 分成三类。
非推理 reranker
例如:
- MonoT5;
- RankLLaMA。
它们直接输出相关性分数,不是专门为 BRIGHT 的复杂推理训练的。
Reasoning but Non-Thinking
模型具有推理型排序能力,但推理时不显式生成长推理过程,例如:
- Qwen 系列 reranker;
- TFRank。
Reasoning and Thinking
模型在给相关性判断之前,会显式生成 reasoning trace,例如:
- Rank1。
这里的 “thinking” 不是说模型真的有人类意识,而是:
模型在输出相关性标签前,先生成一段显式推理文本
动机
当前很多推理检索方法主要依赖:
- 更大的 embedding 模型;
- 更强的 reasoning retriever;
- 生成查询推理链;
- 更大的 LLM reranker。
这些路线通常意味着更多:
- 训练成本;
- 推理成本;
- GPU 显存;
- 查询延迟。
但 GAR 不训练新模型,它主要改变:
reranker 的预算该花在哪些文档上。
如果 GAR 在 BRIGHT 这类困难任务中仍有效,那么系统可能不用不断扩大模型,而是通过更聪明地选择候选文档获得提升。论文将这个动机概括为:
rerank smarter,而不只是使用 bigger reranker。
论文没有提出一个全新的 GAR 算法,而是围绕三个复现问题展开:
RQ1
GAR 在推理密集型检索上仍然有效吗?
RQ2
不同 reranker 提供的反馈信号,会怎样影响 GAR?
RQ3
GAR 对 batch size 和 graph neighborhood size 等超参数是否稳定?
实验设置
相关数据集
数据集:BRIGHT
论文只使用了一个主 benchmark:
BRIGHT:A Realistic and Challenging Benchmark for Reasoning-Intensive Retrieval
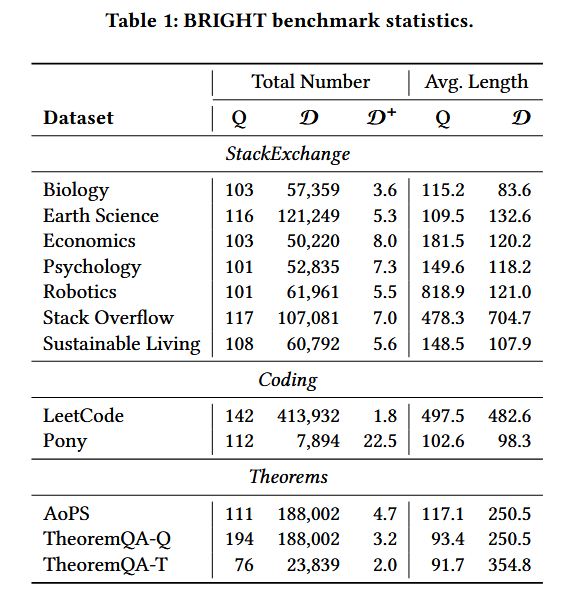
BRIGHT 包含 12 个子任务,分为三组。
StackExchange 类
- Biology;
- Earth Science;
- Economics;
- Psychology;
- Robotics;
- Stack Overflow;
- Sustainable Living。
Coding 类
- LeetCode;
- Pony。
Theorem 类
- AoPS;
- TheoremQA-Q;
- TheoremQA-T。
不同子任务大约包含:
- 76–194 个 query;
- 7,894–413,932 篇候选文档;
- 每个 query 平均约 1.8–22.5 篇相关文档。 2604.27577v1
BRIGHT 的关键特点是:
相关性不能仅通过关键词或普通语义相似判断,而需要理解程序逻辑、科学解释或数学方法。
核心方法:GAR
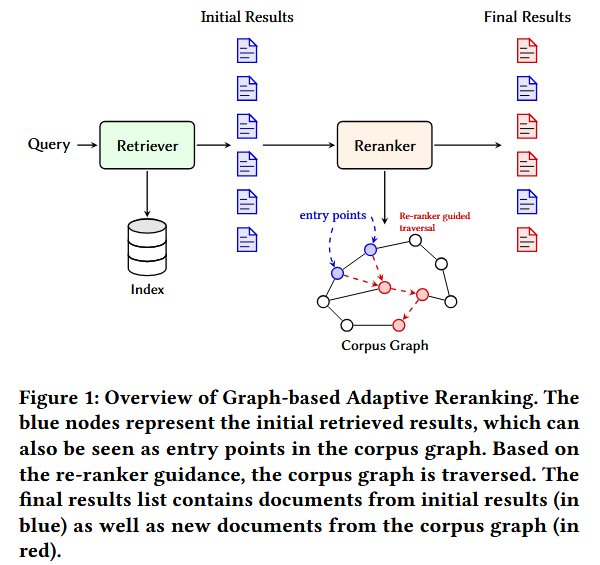
假设:
- (R_0):BM25 初始排序结果;
- (F):图前沿;
- (R_1):最终已重排结果;
- (b):每批重排多少篇文档;
- (k):每个文档有多少图邻居;
- (c):总重排预算。
完整流程如下。
第一步:初始 BM25 检索
Query
  ↓
BM25
  ↓
初始排序 R0
第二步:重排前 (b) 篇
把 (R_0) 中前 (b) 篇交给 reranker:
Reranker(Query, Document)
→ relevance score
然后将结果加入 (R_1)。
第三步:根据高分文档建立图前沿
找到这些文档在 corpus graph 中的邻居。
如果文档 A 被 reranker 打了高分,A 的邻居就获得较高优先级。
原 GAR 的一个简化做法是:
邻居暂时继承来源文档的 reranker 分数。
例如:
A得分0.9
A的邻居B、C、D
→ 暂时都获得0.9的优先级
第四步:交替从初始列表和图前沿取文档
GAR 不是完全抛弃初始 BM25 列表,而是交替处理:
一批来自 R0
下一批来自 F
再一批来自 R0
再一批来自 F
这样既保留普通检索结果,也有机会探索初始 Top-(k) 之外的邻居。
第五步:直到消耗完重排预算
当:
|R_1|=c算法停止,返回所有已评分文档的最终排序。
实验结果
核心结果一:GAR 对强推理 reranker 普遍有效
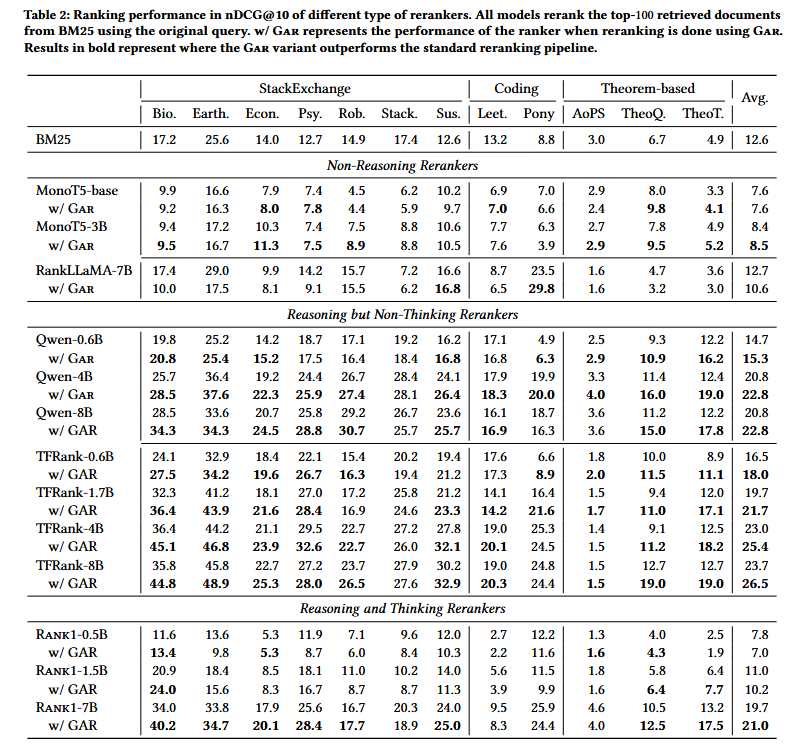
在重排预算为 100 时,平均 nDCG@10 如下:
| Reranker | 原始重排序 | 加入 GAR | 变化 |
|---|---|---|---|
| Qwen-0.6B | 14.7 | 15.3 | +0.6 |
| Qwen-4B | 20.8 | 22.8 | +2.0 |
| Qwen-8B | 20.8 | 22.8 | +2.0 |
| TFRank-0.6B | 16.5 | 18.0 | +1.5 |
| TFRank-1.7B | 19.7 | 21.7 | +2.0 |
| TFRank-4B | 23.0 | 25.4 | +2.4 |
| TFRank-8B | 23.7 | 26.5 | +2.8 |
| Rank1-7B | 19.7 | 21.0 | +1.3 |
最好的结果来自:
TFRank-8B + GAR:26.5而 TFRank-8B 原始值为:
23.7论文第 5 页 Table 2 很直观地展示出:绝大多数中等或较强的推理型 reranker,在加上 GAR 后都会提高。
在个别子任务上提升尤其明显。例如论文报告:
- Biology 上 TFRank-8B 加 GAR,nDCG@10 相对提升最高约 25.1%;
- TheoremQA-Q 和 TheoremQA-T 上,部分设置相对提升接近 49.6%。
作者把这些提升归因于 GAR 找到了 BM25 初始候选之外的相关文档。 2604.27577v1
核心结果二:GAR 不是“加上就一定有效”,弱 reranker 会把图搜索带偏
并不是所有模型都受益。
| 较弱 Reranker | 原始重排序 | 加入 GAR |
|---|---|---|
| MonoT5-base | 7.6 | 7.6 |
| MonoT5-3B | 8.4 | 8.5 |
| RankLLaMA-7B | 12.7 | 10.6 |
| Rank1-0.5B | 7.8 | 7.0 |
| Rank1-1.5B | 11.0 | 10.2 |
这说明 GAR 的逻辑不是:
有图
→ 自动变好
而是:
高质量 reranker 信号
→ 选择正确相关文档
→ 扩展正确邻域
→ 找到更多相关文档
反过来:
低质量 reranker 信号
→ 高估无关文档
→ 扩展无关文档的邻居
→ 噪声越来越多
作者明确指出,RankLLaMA 和 MonoT5 在 BRIGHT 上本身就不擅长复杂推理,有些甚至低于 BM25,因此它们提供的图遍历反馈不可靠,最终会优先选择错误邻域。 2604.27577v1
这是全文最重要的边界条件:
GAR 放大的是 reranker 的反馈能力;好的反馈会被放大,坏的反馈也可能被放大。
核心结果三:小模型 + GAR 可以超过更大的模型
论文发现:
使用更聪明的搜索策略,有时比单纯扩大 reranker 更有效。
例如:
TFRank-1.7B + GAR:21.7
Qwen-4B:20.8
Qwen-8B:20.8
Rank1-7B:19.7
也就是说,只有 1.7B 参数的 TFRank 配合 GAR,平均表现超过了若干 4B、7B 和 8B 的普通 reranker。 2604.27577v1
论文第 9 页 Figure 7 清楚展示:
- 横轴是模型规模;
- 实线表示加 GAR;
- 虚线表示原模型;
- 对较强模型,GAR 曲线通常位于原模型之上。
作者因此认为:
系统优化不能只问“模型是否更大”,还要问“昂贵的模型判断是否被用在正确的候选上”。
补充结果一:GAR 提高了召回率
GAR 不只是重新排列已有候选,还能找到新候选。
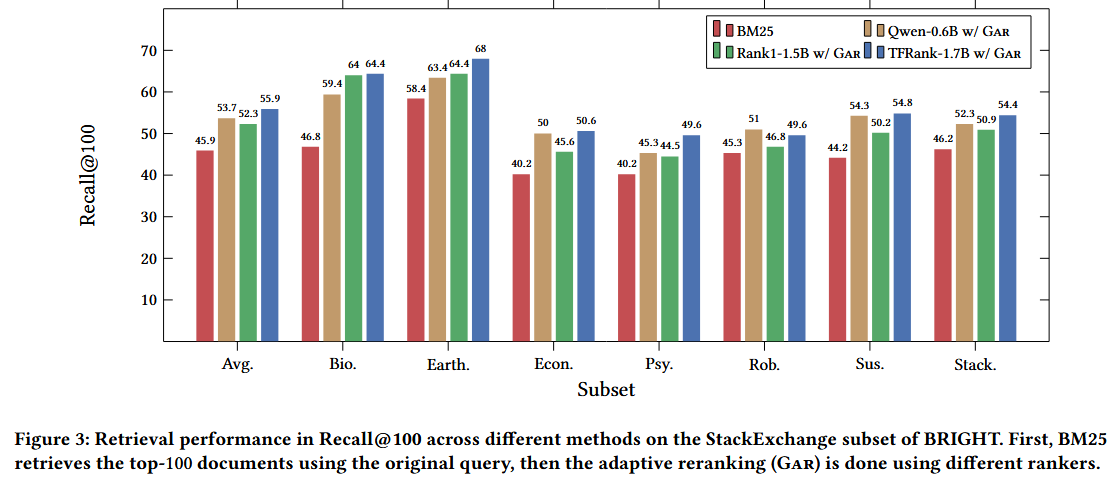
在 StackExchange 子任务上,论文报告 Recall@100 在部分设置下最高可提升约 36.8%;图中多数强 reranker + GAR 的召回率均高于原始 BM25。
这直接说明 GAR 的提升来源并不只是:
把原 Top-100 重新排得更好,
还包括:
从 corpus graph 中引入初始 Top-100 以外的相关文档。
补充结果二:重排 50 篇,有时可以达到普通重排 100 篇的效果
论文降低重排预算到 50 后发现:
- TFRank-1.7B 普通重排 100 篇,在 Biology 上 nDCG@10 为 32.3;
- TFRank-1.7B + GAR 只重排 50 篇,达到 34.9。
这表明 GAR 有可能以一半重排预算达到或超过普通流水线。
不过需要注意:
论文没有为这次复现重新做完整 wall-clock latency 实验,而是引用原 GAR 工作中约 3–4ms/100 documents 的额外图管理开销,并表示其运行中没有观察到明显差异。
相关意义
复杂检索不一定只能靠更大的模型解决
目前常见路线是:
检索难度提高
→ 换更大的 embedding
→ 换更大的 reasoning reranker
→ 增加 test-time reasoning
这篇论文说明还有另一条路线:
固定 reranker
→ 改变候选选择机制
→ 让 reranker 引导图遍历
它不增加模型训练,仅修改查询时的候选探索策略。
第一阶段召回和第二阶段判断应当形成反馈闭环
传统多阶段检索是单向的:
Retriever → RerankerGAR 变成:
Retriever
   ↓
Reranker
   ↓ relevance feedback
Corpus Graph
   ↓
更多候选
   ↓
Reranker
也就是说,reranker 不再只是最后的裁判,而开始反向影响:
下一批应该检索什么。
这使检索和重排序从完全割裂的模块,变成一个弱反馈闭环。
图结构本身不是充分条件,反馈信号质量才是关键
论文最深的结论不是:
图检索总是有效。
而是:
\text{GAR效果} \approx f(\text{reranker质量},\text{初始检索质量},\text{语料图质量})作者在结论中明确说:
- GAR 的表现与基础 reranker 的表现高度相关;
- 如果 reranker 反馈很弱,GAR 可能降低效果;
- 初始检索和 corpus graph 的质量同样会影响结果。
实践意义:训练免费、可插拔
GAR 不需要:
- 重新训练 retriever;
- 微调 reranker;
- 蒸馏新模型;
- 改变模型参数。
它只需要:
- 离线建立 corpus graph;
- 查询时根据 reranker 反馈改变候选调度。
因此作者将其视为一个:
training-free、complementary module
即一个无需额外训练、可以叠加到已有强 reranker 上的模块。
局限性
只测试 BRIGHT 一个 benchmark
虽然 BRIGHT 有 12 个领域,但它仍然只是一个 benchmark 家族。
没有测试:
- FollowIR;
- FreshStack;
- M-BEIR;
- 真实企业搜索;
- 长文档 RAG;
- 多语言检索。
因此结论应理解为:
GAR 在 BRIGHT 上可以迁移到推理密集设置,
而不是已经证明对所有复杂检索都有效。
只使用 BM25 构建 corpus graph
原始 GAR 可以使用:
- 稀疏 BM25 图;
- 稠密 embedding 图。
本文由于资源限制只测试 BM25 图,并明确把其他图结构留给未来工作。
这会带来一个问题:
当前结果究竟是 GAR 的普遍规律,还是 BM25 词法邻域在 BRIGHT 上的特殊表现?
论文不能完全回答。
邻居全部继承源文档分数,过于粗糙
如果高分文档 A 的邻居有:
B:真正相关
C:主题相似但无关
D:错误方向
GAR 会暂时给 B、C、D 相同的优先级。
论文自己指出:
GAR 无法区分同一来源文档的不同邻居,导致 (k) 过大时噪声增加。
这是方法本身很明显的改进空间:
- 对邻居单独估分;
- 结合 source score 与 edge similarity;
- 学习 graph frontier priority;
- 使用 uncertainty-aware expansion。
总结
- 传统重排序只能处理第一阶段找出的 Top-(k),因此存在 bounded recall:没被初始检索找到的相关文档,reranker 永远看不到。
- GAR 让 reranker 的高分文档成为语料图的探索入口,从其邻居中继续寻找新的相关文档。
- 在 BRIGHT 上,GAR 能显著提升 Qwen、TFRank 和较大 Rank1 等强推理 reranker,但对 RankLLaMA、小型 Rank1 等弱反馈模型可能无效甚至有害。
- 这篇论文真正的结论不是“图搜索一定有效”,而是“高质量 reranker 反馈 + 合理语料图可以低成本突破初始召回上限;坏反馈则会把图搜索带向错误方向”