DeeBERT: Dynamic Early Exiting for Accelerating BERT Inference
论文链接:https://arxiv.org/pdf/2004.12993 引用709
这篇论文正式发表于 ACL 2020 主会,作者为 Ji Xin、Raphael Tang、Jaejun Lee、Yaoliang Yu 和 Jimmy Lin;作者公开了可复现代码。
中文可译为:
DeeBERT:通过动态提前退出加速 BERT 推理
相关概念
BERT 与 RoBERTa
BERT 是一种由多层 Transformer 组成的预训练语言模型。以 BERT-base 为例,它包含 12 层 Transformer。
可以粗略理解为:
输入句子
  ↓
第1层:处理浅层词汇和局部信息
  ↓
第2层:进一步组合上下文
  ↓
……
  ↓
第12层:输出最终语义表示
RoBERTa 与 BERT 架构相近,但采用了不同、通常更充分的预训练策略。
标准做法是:无论输入简单还是困难,每个样本都必须运行全部层。
Off-ramp:退出匝道
论文把每个中间层后面增加的分类器称为 off-ramp,中文可理解为“退出匝道”。
类比高速公路:
Transformer第1层 → 出口1
          ↓
Transformer第2层 → 出口2
          ↓
……
          ↓
Transformer最后一层 → 最终出口
每到一个出口,模型都判断:
当前信息是否已经足以作出可靠预测?
如果足够可靠,就从这里离开;否则继续运行。
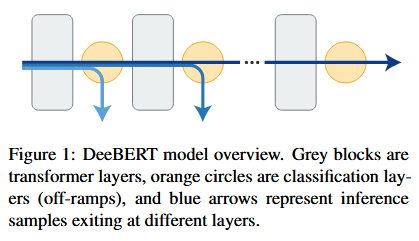
论文第一页 Figure 1 很直观地展示了这一结构:灰色模块是 Transformer 层,橙色圆形是中间分类器,蓝色箭头表示不同样本可以在不同层退出。
GLUE
GLUE 是一个用于评估语言理解模型的综合基准。
论文使用其中六个数据集:
| 数据集 | 主要任务 | 通俗解释 |
|---|---|---|
| SST-2 | 情感分类 | 判断句子表达正面还是负面情感 |
| MRPC | 复述判断 | 判断两个句子是不是表达同一个意思 |
| QQP | 重复问题判断 | 判断两个问题是不是重复问题 |
| QNLI | 问答式自然语言推理 | 判断句子是否包含问题的答案 |
| RTE | 文本蕴含 | 判断一个句子能否推出另一个句子 |
| MNLI | 多领域自然语言推理 | 判断两段文本是蕴含、矛盾还是中立 |
论文同时在 BERT 和 RoBERTa 上进行实验。
动机
BERT、RoBERTa 等模型显著提高了自然语言处理效果,但也存在:
- 参数量较大;
- 推理速度慢;
- 实时服务延迟高;
- 移动设备和边缘设备部署困难;
- 每个请求都运行完整模型会消耗较多计算资源。
论文特别关注:
- 实时应用;
- 手机、手表等硬件受限设备;
- 需要大量请求并发的线上系统。
论文研究的核心问题是:
能否根据每个输入样本的难度,动态决定 BERT 需要运行多少层,从而减少不必要的推理计算?
标准 BERT 的问题是:
简单样本 → 运行12层
困难样本 → 运行12层
例如下面的情感分类样本:
“这是一部非常糟糕的电影。”模型可能在较浅层已经能非常确定它是负面情感。
但标准 BERT 仍然必须运行后面的所有层。
作者提出的假设是:
BERT 中间层已经能够为一部分简单样本提供足够的分类信息,没有必要让这些样本继续运行完整模型。
核心贡献
DeeBERT 在 BERT 每个 Transformer 层后增加一个中间分类器,让简单样本在模型足够自信时提前停止计算,从而在准确率几乎不下降的情况下节省最高约 40% 的推理时间。
通俗易懂一点即为:
并非每个问题都需要模型“思考到底”,DeeBERT 让容易的问题提前回答,把完整计算只留给困难问题。
实验设置
论文在六个 GLUE 分类数据集上测试:
- SST-2
- MRPC
- QNLI
- RTE
- QQP
- MNLI
并分别使用:
- BERT-base
- RoBERTa-base
另外还对 BERT-large 和 RoBERTa-large 做了扩展分析。
实际推理时间在一张 NVIDIA Tesla P100 GPU 上测量;测试时样本逐个送入模型,而不是使用大批量并行。
核心方法
DeeBERT 的方法分为结构改造、训练和推理三个部分。
第一步:在每层之后增加一个分类器
标准 BERT:
Transformer 1
    ↓
Transformer 2
    ↓
……
    ↓
Transformer 12
    ↓
最终分类器
DeeBERT:
Transformer 1 → 分类器1
    ↓
Transformer 2 → 分类器2
    ↓
……
    ↓
Transformer 12 → 分类器12
后一个分类器就是标准 BERT 原本的分类器。
论文并不修改预训练阶段,而只改变下游任务的微调与推理方式。
第二步:采用两阶段微调
这是 DeeBERT 容易被忽略但很重要的设计。
第一阶段:正常微调完整 BERT
作者更新:
- embedding 层;
- 所有 Transformer 层;
- 最后一层分类器。
训练目标只使用最后分类器的损失。
也就是先得到一个正常、性能较好的标准 BERT。
第二阶段:训练中间分类器
作者随后:
- 冻结 embedding;
- 冻结所有 Transformer 层;
- 冻结最后分类器;
- 只训练前面的中间分类器。
这样做是为了避免中间出口的训练破坏最终出口的表现。
换句话说:
先确保完整模型性能不受损,再训练中间层如何尽早预测。
第三步:推理时逐层检查预测熵
样本运行到第 (i) 层时:
- 中间分类器输出预测概率 (z_i);
- 计算预测分布的熵;
- 如果熵低于阈值 (S),说明模型足够自信;
- 立即输出;
- 否则继续下一层。
伪代码可以简化为:
for layer in model_layers: hidden_state = layer(hidden_state) prediction = classifier[layer](hidden_state) if entropy(prediction) < threshold: return predictionreturn final_prediction论文的 Algorithm 1 就是这一过程。
第四步:通过阈值控制质量与速度
阈值 (S) 越大:
- 退出条件越宽松;
- 越多样本较早退出;
- 推理速度越快;
- 准确率风险越大。
阈值 (S) 越小:
- 只有特别自信时才退出;
- 更多样本运行到较深层;
- 速度较慢;
- 质量更接近完整模型。
因此,同一个 DeeBERT 可以通过改变阈值,提供多个运行档位:
高精度档
平衡档
高速档
实验结果
核心结果一:准确率几乎不变时,可以节省约 20%–40% 推理时间
论文最重要的结果是:
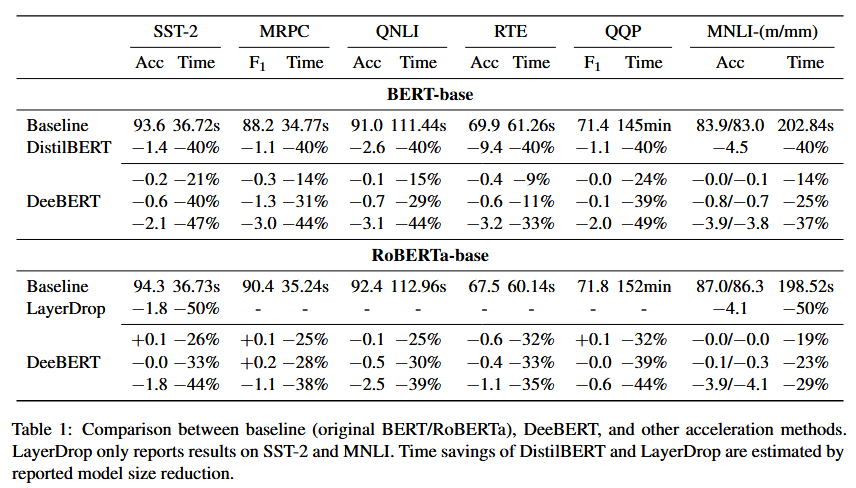
在大多数数据集上,DeeBERT 可以在准确率或 F1 只下降很少的情况下,节省相当比例的实际 wall-clock 推理时间。
一些典型例子:
BERT-base
- SST-2:节省约 40% 时间,准确率下降约 0.6 个点;
- QQP:节省约 39% 时间,F1 下降约 0.1 个点;
- MNLI:节省约 25% 时间,准确率下降约 0.7–0.8 个点。
RoBERTa-base
- QQP:节省约 39% 时间,F1 基本不下降;
- RTE:节省约 33% 时间,准确率下降约 0.4 个点;
- SST-2:节省约 33% 时间,准确率基本不下降。
这些结果说明,很多样本确实不需要运行完整网络。 2004.12993v1
论文第 3 页 Table 1 是这一结论最直接的证据:表中同时报告了性能变化和实际运行时间变化。
核心结果二:性能在达到某个“转折点”前基本稳定,之后会快速下降
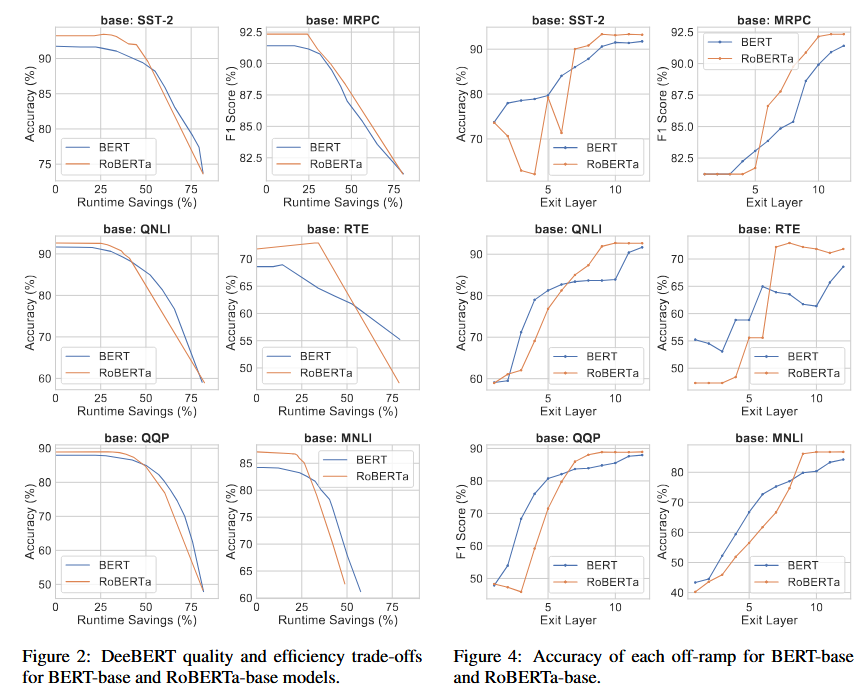
作者发现,质量—效率曲线通常具有明显的阶段性:
低到中等程度提前退出:
速度提高,但性能基本保持

超过某个转折点:
继续追求加速,性能开始快速下降
这说明模型确实包含一定冗余,但这种冗余并不是无限的。
例如:
节省20%~30%时间
→ 可能几乎不影响性能

节省60%~80%时间
→ 准确率通常明显恶化
因此,DeeBERT 最有价值的工作区间不是“极限加速”,而是:
找到性能开始明显下降之前的最佳运行点。
这一模式在 BERT 与 RoBERTa、多个 GLUE 数据集上均能观察到。
论文第 4 页左侧的 Figure 2 展示了各任务中推理时间节省比例与性能之间的曲线。
核心结果三:BERT 和 RoBERTa 各层形成有效信息的方式不同,并存在明显冗余层
作者强制所有样本在同一层退出,然后观察每一层的分类能力。
结果发现:
BERT
BERT 的性能通常随层数增加而比较稳定地提高:
浅层较弱
中层逐渐改善
深层继续提高
RoBERTa
RoBERTa 的层间变化更加不均匀:
前几层可能几乎不改善
某几个关键层突然明显提升
随后较早达到饱和
作者还发现:
- 有些后层几乎没有进一步提高性能;
- 某些层甚至比前一层略差;
- 很少有样本选择从这些“没有增益”的层退出;
- 样本更倾向在带来明显性能跃升的层退出。
这支持了一个重要发现:
Transformer 的每一层并不是都同样有用,模型存在层级冗余,而且不同模型的有用信息分布方式不同。
论文第 4 页右侧 Figure 4 和第 5 页 Figure 6 是理解这一结论的关键图。
补充结果:理论节省量与实际时间节省高度一致
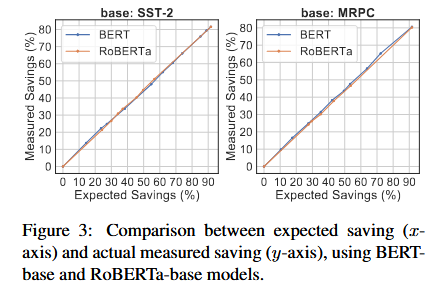
作者定义了一个 expected saving 指标:
1- \frac{\sum_{i=1}^{n} iN_i} {\sum_{i=1}^{n} nN_i}其中:
- (n):模型总层数;
- (N_i):在第 (i) 层退出的样本数。
它表示提前退出节省了多少层计算。
实验发现,这个理论指标与实际测量的 wall-clock 时间节省近似线性对应,说明“少运行多少层”在其测试设置下可以较好预测真实加速。
相关意义
1 不同输入需要的计算量不同
DeeBERT 最重要的思想是:
输入难度不同,不应该一律使用相同计算预算。
标准 BERT 是固定深度推理:
\text{每个样本都运行 }n\text{ 层}DeeBERT 则是动态深度:
\text{使用层数}=f(\text{样本难度})容易样本可能只运行几层,困难样本运行完整网络。
这将“模型复杂度”从固定属性变成了:
随输入动态变化的计算过程。
2 中间表示不只是过渡状态,也可以直接完成任务
传统理解通常把中间层看作:
尚未完成的表示但论文证明,对于一部分样本,中间层已经包含足以完成分类的信息。
因此,深层模型并不是所有输入都必须完全执行。
3 提前退出比固定压缩提供更灵活的部署方式
DistilBERT 等蒸馏方法通常生成一个固定的小模型:
原始12层
↓
压缩成固定6层
无论样本简单还是困难,都只使用这 6 层。
DeeBERT 不同:
简单样本:3层
普通样本:7层
困难样本:12层
而且用户可以根据业务需要改变熵阈值:
- 低延迟场景选择更宽松阈值;
- 高质量场景选择更严格阈值。
作者还强调,DeeBERT 不要求重新进行成本高昂的模型预训练,只需要在下游任务微调阶段增加中间分类器。
4 对后续研究的影响
这篇论文的重要价值不只是节省约 40% 时间,而是推动了一个研究方向:
模型能否根据输入难度动态分配推理计算?
后续研究可以继续探索:
- 更好的退出指标;
- 更可靠的置信度校准;
- 联合训练所有出口;
- token 级提前退出;
- 层跳跃;
- 跨域阈值适配;
- 大语言模型中的动态深度。
局限性
每个数据集需要单独选择阈值
作者根据各数据集的开发集选择不同熵阈值。
这意味着不存在一个被证明可以通用于所有任务的统一阈值。
如果部署环境发生变化,例如:
- 输入领域变化;
- 类别分布变化;
- 数据难度变化;
- 出现训练时未见样本;
原来的阈值可能不再合适。
低熵不一定代表预测正确
DeeBERT 的核心假设是:
\text{低熵}\Rightarrow\text{高可靠性}但神经网络可能:
非常自信地预测错误答案特别是在:
- 分布外输入;
- 对抗样本;
- 域外数据;
- 模型概率没有良好校准时。
论文没有深入评估:
- 置信度校准;
- Expected Calibration Error;
- 域外错误;
- 自信但错误的提前退出。
因此,熵是简单有效的指标,但未必总是可靠。
缺少多随机种子和统计置信区间
论文没有系统报告:
- 多个随机种子均值;
- 标准差;
- bootstrap 置信区间;
- 显著性检验。
部分 GLUE 数据集较小,例如 RTE,结果可能对随机初始化比较敏感。
总结
本文提出了DeeBERT,这是一种有效的方法,利用BERT模型中的冗余性,实现更好的质量与效率权衡。实验显示其能够将BERT和RoBERTa的推断加速高达约40%,并揭示BERT模型中不同transformer层的有趣模式。